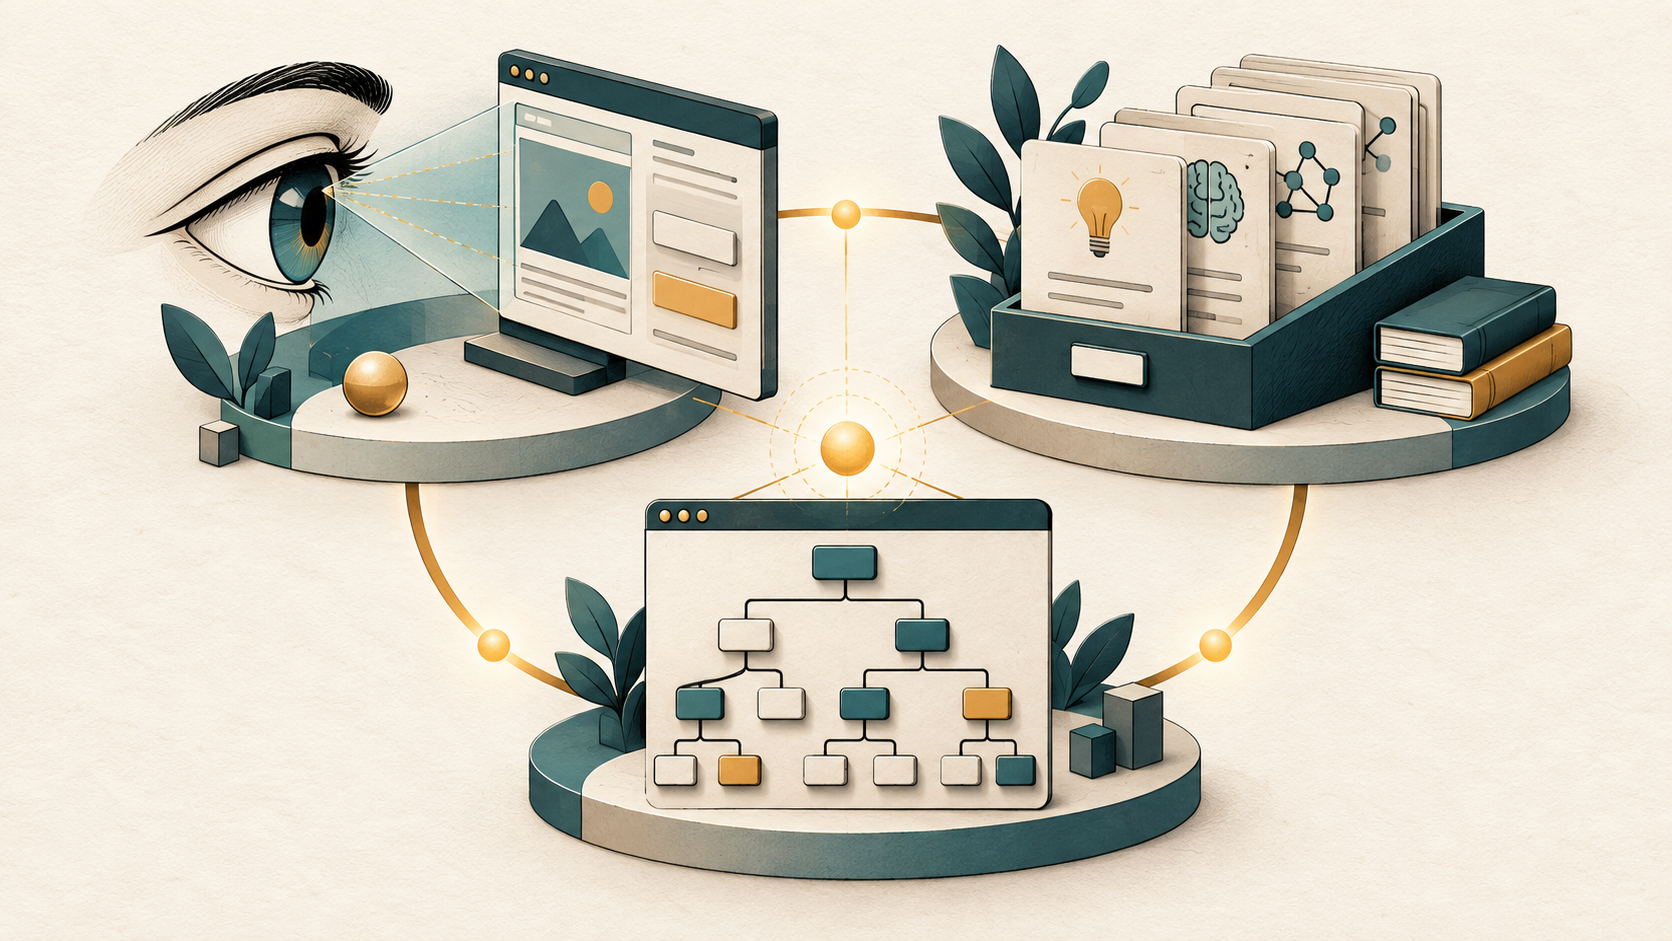
AI / LLM 在 UI 自动化测试中的常见用法可以分为三类:
- 视觉方案
- RAG / Knowledge Base 方案
- LLM + DOM / 对象树方案
这三类方案各有优势和短板,适用场景也不同。
1. 视觉方案
视觉方案最直观:把当前界面截图给模型,让模型像人一样“看屏幕”,再根据任务目标决定下一步点击哪里、输入什么。
典型输入是:
截图 + 用户目标
比如:
请完成登录流程
请找到充值入口
请判断当前页面是否有错误提示
视觉方案的优势包括:
- 不依赖 DOM 或控件树
- 对游戏、远程桌面、原生客户端更通用
- 更接近人类真实使用软件的方式
- 对 WebView、Canvas、Unity、Qt 这类场景更友好
它也有几个局限。
第一,纯视觉定位不稳定。模型知道“按钮大概在右下角”,但执行点击时仍需把语义映射成准确坐标。这个过程容易受分辨率、缩放、遮挡、动画影响。
第二,视觉方案很难理解隐藏状态。比如一个按钮是不是 disabled、一个元素是不是可点击、一个弹窗是不是阻塞主流程,单靠截图不一定可靠。
第三,长流程成本高。每一步都截图、识别、推理,延迟和 token 成本都会上来。
视觉方案适合作为兜底或跨端泛化能力,尤其适合无法获取 DOM / 对象树的场景。能够取得结构化信息时,定位和执行通常会更稳定。
2. RAG / Knowledge Base 方案
第二类是 RAG 或 Knowledge Base。
RAG 会保存已有的自动化资产、测试用例、页面知识和业务流程。执行任务时先检索相关内容,再让 LLM 基于这些上下文生成步骤或判断。
典型输入是:
用户目标 + 检索到的历史用例 / 页面知识 / 业务文档
这种方案的优点是:
- 对业务流程理解更强
- 能复用历史自动化资产
- 更适合复杂业务系统
- 可以把隐性知识显式沉淀下来
- 对回归测试、用例生成、影响分析很有价值
但它有一个前提:必须有历史资产。
如果团队本来就没有足够的自动化用例、页面说明、业务文档、操作日志,那么 RAG 很容易变成“空库检索”。没有知识沉淀,RAG 就只能检索到一些泛泛的内容,最后还是靠 LLM 猜。
RAG 自动化落地时经常出现下面两种情况:
方案看起来很完整,但知识库里没东西。
或者:
有文档,但文档和真实系统不一致。
3. LLM + DOM / 对象树方案
第三类是 LLM + DOM / 对象树。
Web 场景里是 DOM、Accessibility Tree;Unity 里可能是 Poco 树;Android 是 UIAutomator 层级;iOS 是 Appium / XCTest 树;Windows 是 UIA 树。
这种方案把当前界面上的可交互元素整理成结构化数据交给模型。
比如:
[1] 登录按钮 button enabled
[2] 手机号输入框 input empty
[3] 密码输入框 input empty
[4] 忘记密码 link
然后让 LLM 根据任务选择动作:
click element 1
input element 2: xxx
这种方案的优势是工程上更可控:
- 元素有 ID 或路径,方便点击
- 可以知道控件类型、文本、状态
- 比纯视觉更容易做动作落地
- 更容易记录、回放和调试
- 更适合和传统自动化框架结合
但它的问题也不少。
第一,对象树质量不稳定。Web DOM 很丰富,但可能有大量无意义节点;Unity / 游戏 UI 的对象树可能命名混乱;原生客户端控件树也可能拿不到完整信息。
第二,结构化信息不等于用户看到的信息。有些元素在树里存在,但被遮挡了;有些元素 visible=true,但用户根本点不到;有些 WebView 或 Canvas 内容,树里完全没有。
第三,LLM 依然需要做语义理解。对象树只是告诉模型“有什么”,但不一定告诉它“业务上应该点哪个”。比如页面上有多个“确认”按钮,如果没有业务上下文,模型也会犹豫。
LLM + DOM / 对象树适合作为主要执行通道:
结构化元素负责可控执行,LLM 负责语义决策。
三类方案的对比
三类方案的差异如下:
| 方案 | 优点 | 短板 | 更适合 |
|---|---|---|---|
| 视觉 | 通用,跨端强,不依赖结构 | 坐标不稳定,状态理解弱,成本高 | 游戏、远程桌面、Canvas、兜底识别 |
| RAG / KB | 复用历史经验,业务理解强 | 依赖历史资产,知识维护成本高 | 回归测试、用例生成、复杂业务流程 |
| LLM + DOM / 对象树 | 可控、可执行、易调试 | 树质量不稳定,缺少业务语义 | Web、App、桌面端主流程自动化 |
组合使用
在复杂业务中,可以按以下流程组合三类能力:
- 先从对象树里拿到可交互元素。
- 用 RAG 找到历史流程、页面说明、业务规则。
- 让 LLM 结合任务目标和上下文决策。
- 如果对象树缺失、点击失败、页面异常,再用视觉能力兜底。
组合方案还需要业务断言与恢复规则:每次动作后检查页面是否符合预期,并根据错误类型决定重试、回退或切换执行通道。这部分依赖具体业务的验收标准。