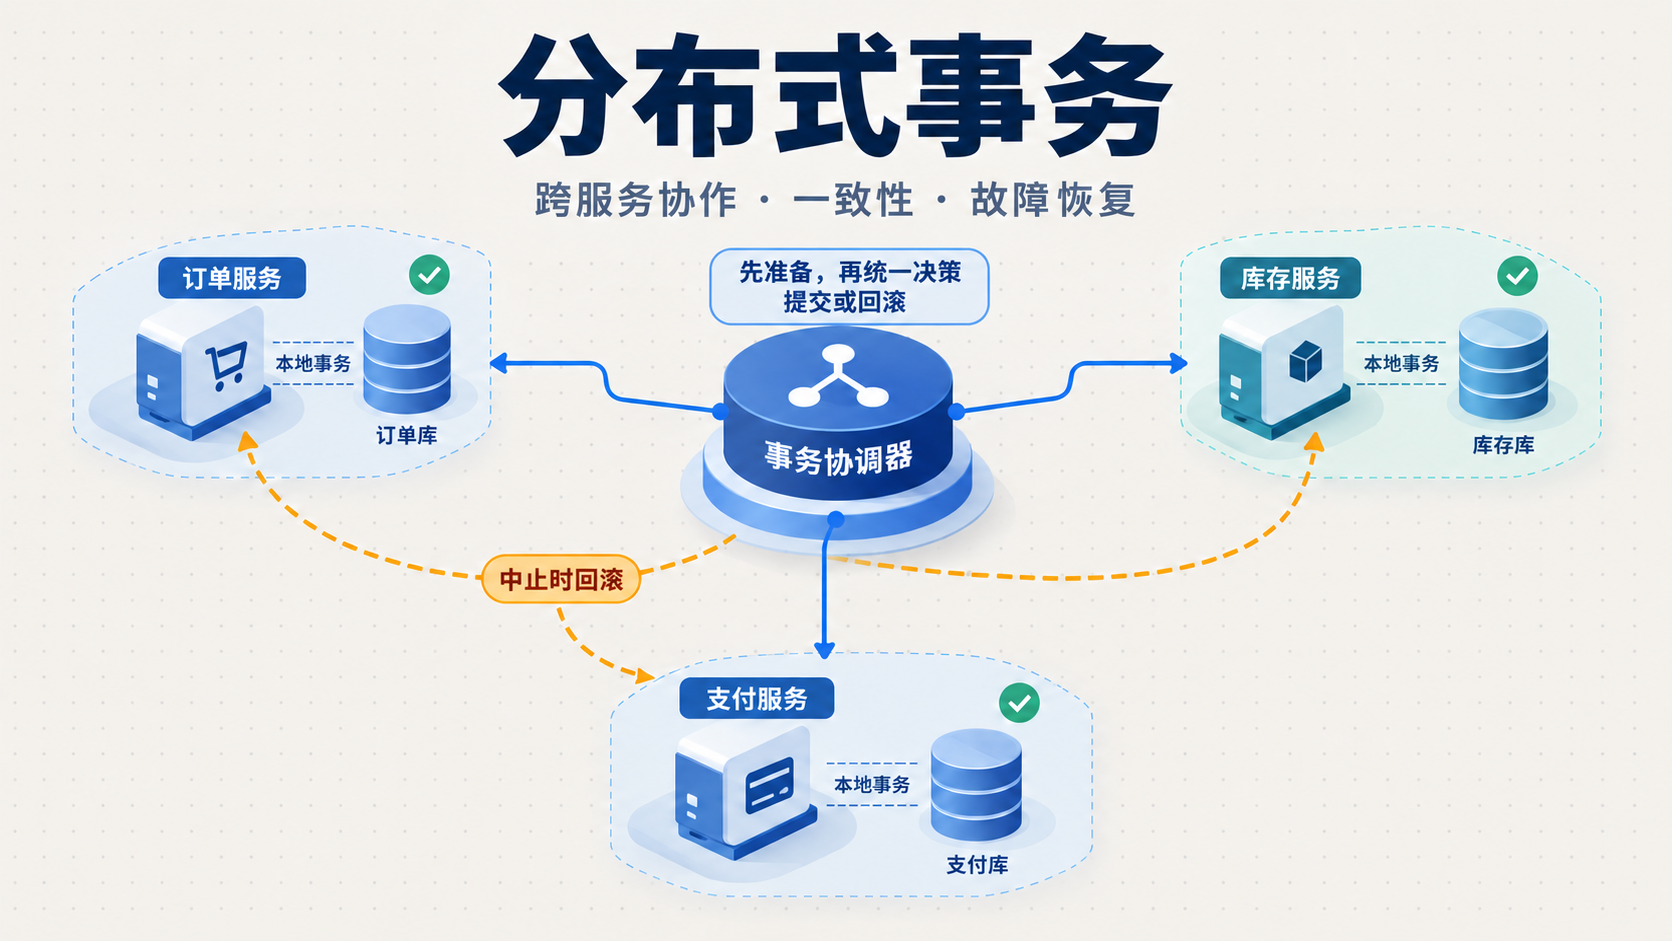
以“下单、库存、支付”为主线,理解分布式事务解决什么问题、常见方案如何工作,以及如何通过开源组件落地、分析性能和验证故障恢复。
本文关注:遇到一个跨服务业务流程时,能够说清事务边界、失败后的结果、恢复责任和方案取舍。
1. 为什么需要分布式事务?
在一个数据库里,创建订单和扣减库存可以放进同一个本地事务:一起提交,或者一起回滚。
业务拆分后,情况变了:
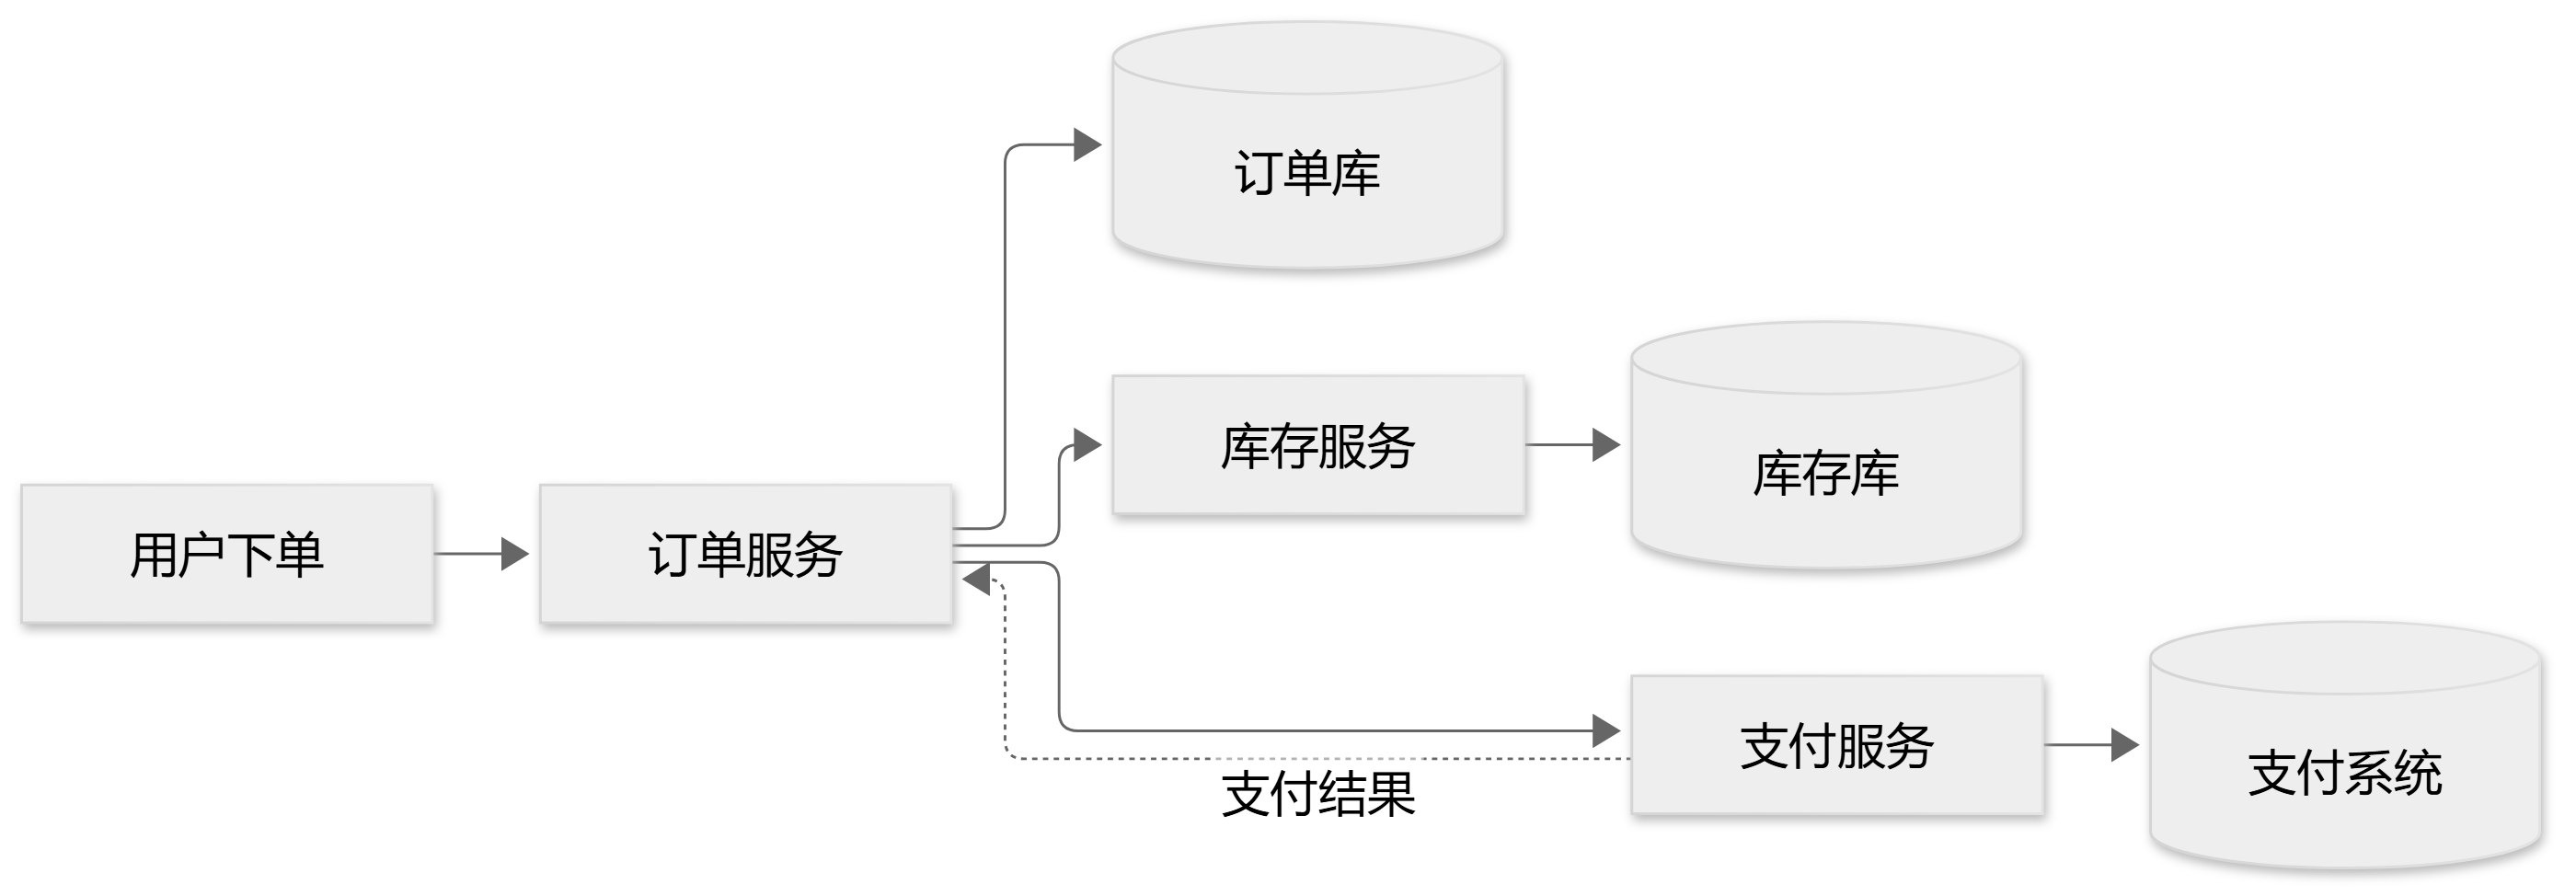
图 1:三个独立的持久化边界。订单库的回滚无法撤销支付系统已经完成的扣款。
每个服务都可以保证自己的本地事务,但整个流程可能只成功一部分:库存已扣,支付失败;支付成功,订单更新失败;支付已成功,返回响应却丢失。
分布式事务讨论的是:多个独立参与方共同完成业务时,如何在部分失败和结果不确定的情况下,维持约定的业务规则。 狭义上指跨资源的原子事务;工程讨论也常包括 Saga、补偿与消息最终一致方案,它们提供的保证不同。
先明确本案例的业务规则:
- 库存不能超卖。
- 同一支付意图不能重复扣款。
- 库存和支付都确认后,订单才能完成。
- 已付款但无法履约时,要有可追踪的退款流程。
这不一定要求三个系统每一瞬间显示相同进度。订单可以暂时显示“处理中”,前提是系统能够可靠推进和恢复。
2. 理解三个关键概念
本地事务有边界
ACID 分别表示原子性、一致性、隔离性和持久性。在服务 A 的本地事务中调用服务 B,并不会自动把 B 的数据库纳入同一个事务。A 回滚时,B 已提交的操作通常仍然存在。
超时不等于失败
调用超时可能意味着请求没到,也可能意味着对方已经成功,只是响应丢失。因此,需要稳定的业务请求号、结果查询和安全重试,不能换个请求号直接重新扣款。
原子提交与最终一致是不同保证
原子提交要求参与方遵循统一的提交或中止决定;最终一致流程允许中间状态,通过可靠推进或补偿达到合法终态。统一提交决定也不自动等于跨系统的所有读取都具有完整隔离保证。
最终一致需要持久记录、重试、对账和异常处理。它不是“过一会儿自然就好了”,也无法在永久故障下无条件保证自动完成。
3. 四类常见方案怎么工作?
3.1 2PC / XA:先准备,再统一决定
2PC 即两阶段提交,由协调者与参与者协作:
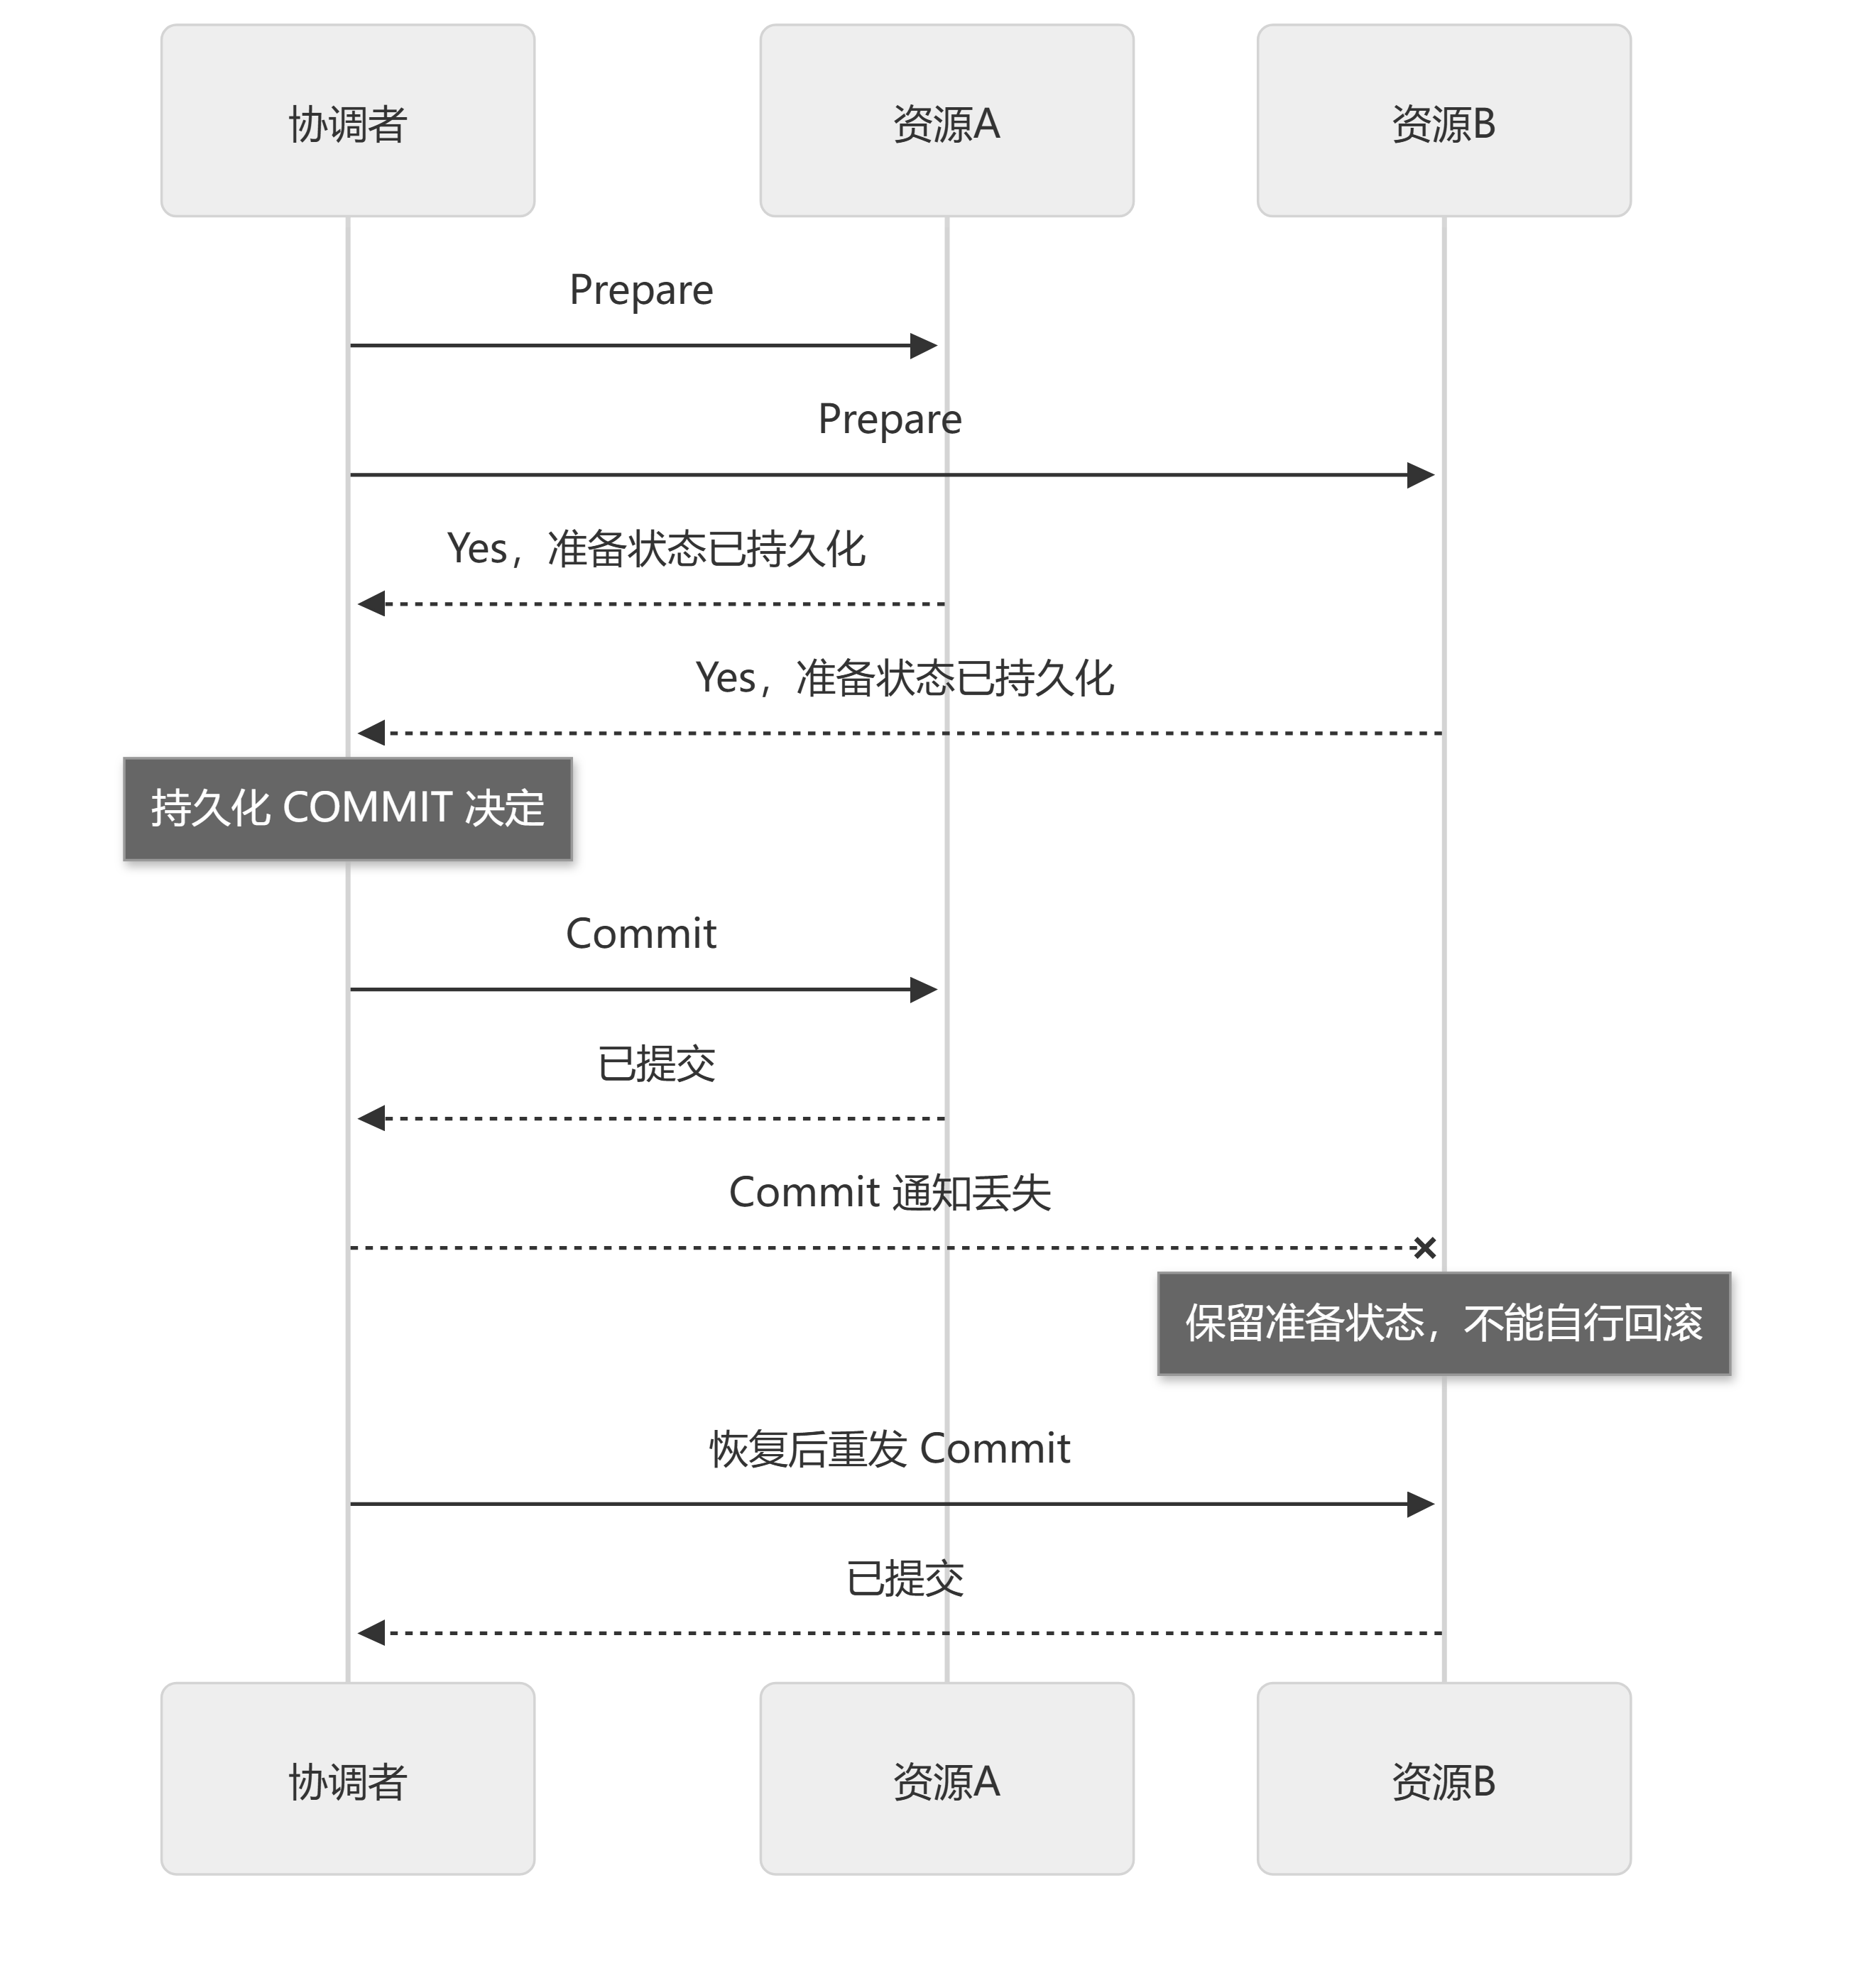
图 2:最危险的窗口是“有人已经提交,另一个参与者还不知道决定”。恢复时必须延续已有决定。
准备完成后,参与者通常仍保留相关资源。如果最终决定暂时不可达,已回答 Yes 的参与者不能仅凭超时随意回滚,因为其他参与者可能已经提交。这是经典 2PC 可能阻塞的原因。
XA 是事务管理器与资源管理器协作的接口规范;2PC 是提交协议,二者不是同义词。
适合评估的场景:资源支持相应协议,事务较短,业务确实需要跨资源原子提交。代价包括协调、持锁和未决事务恢复。参见 Consensus on Transaction Commit 和 PostgreSQL 准备事务说明。
3.2 TCC:先预留,再确认或取消
TCC 即 Try、Confirm、Cancel。以购买两件商品为例:
| 阶段 | 操作 | 资源变化 |
|---|---|---|
| Try | 检查并预留两件库存 | 可售减少 2,预留增加 2 |
| Confirm | 将预留转为实际消耗 | 预留减少 2,已售增加 2 |
| Cancel | 释放预留 | 预留减少 2,可售增加 2 |
Try 不能只是检查“现在有库存”,而应建立后续确认所需的资源条件。每个阶段通常使用本地事务;基础设施故障仍可能导致确认或取消需要重试。
实现必须处理三种情况:
- 幂等:重复 Confirm / Cancel 不重复改变资源。
- 空回滚:Try 没执行,Cancel 已到达,需要记录取消结果。
- 悬挂:取消后迟到的 Try 不能再占用资源。
适合资源能够预留、业务愿意承担接口改造的场景。事务状态和资源修改应原子保存。参见 Seata TCC Fence 说明。
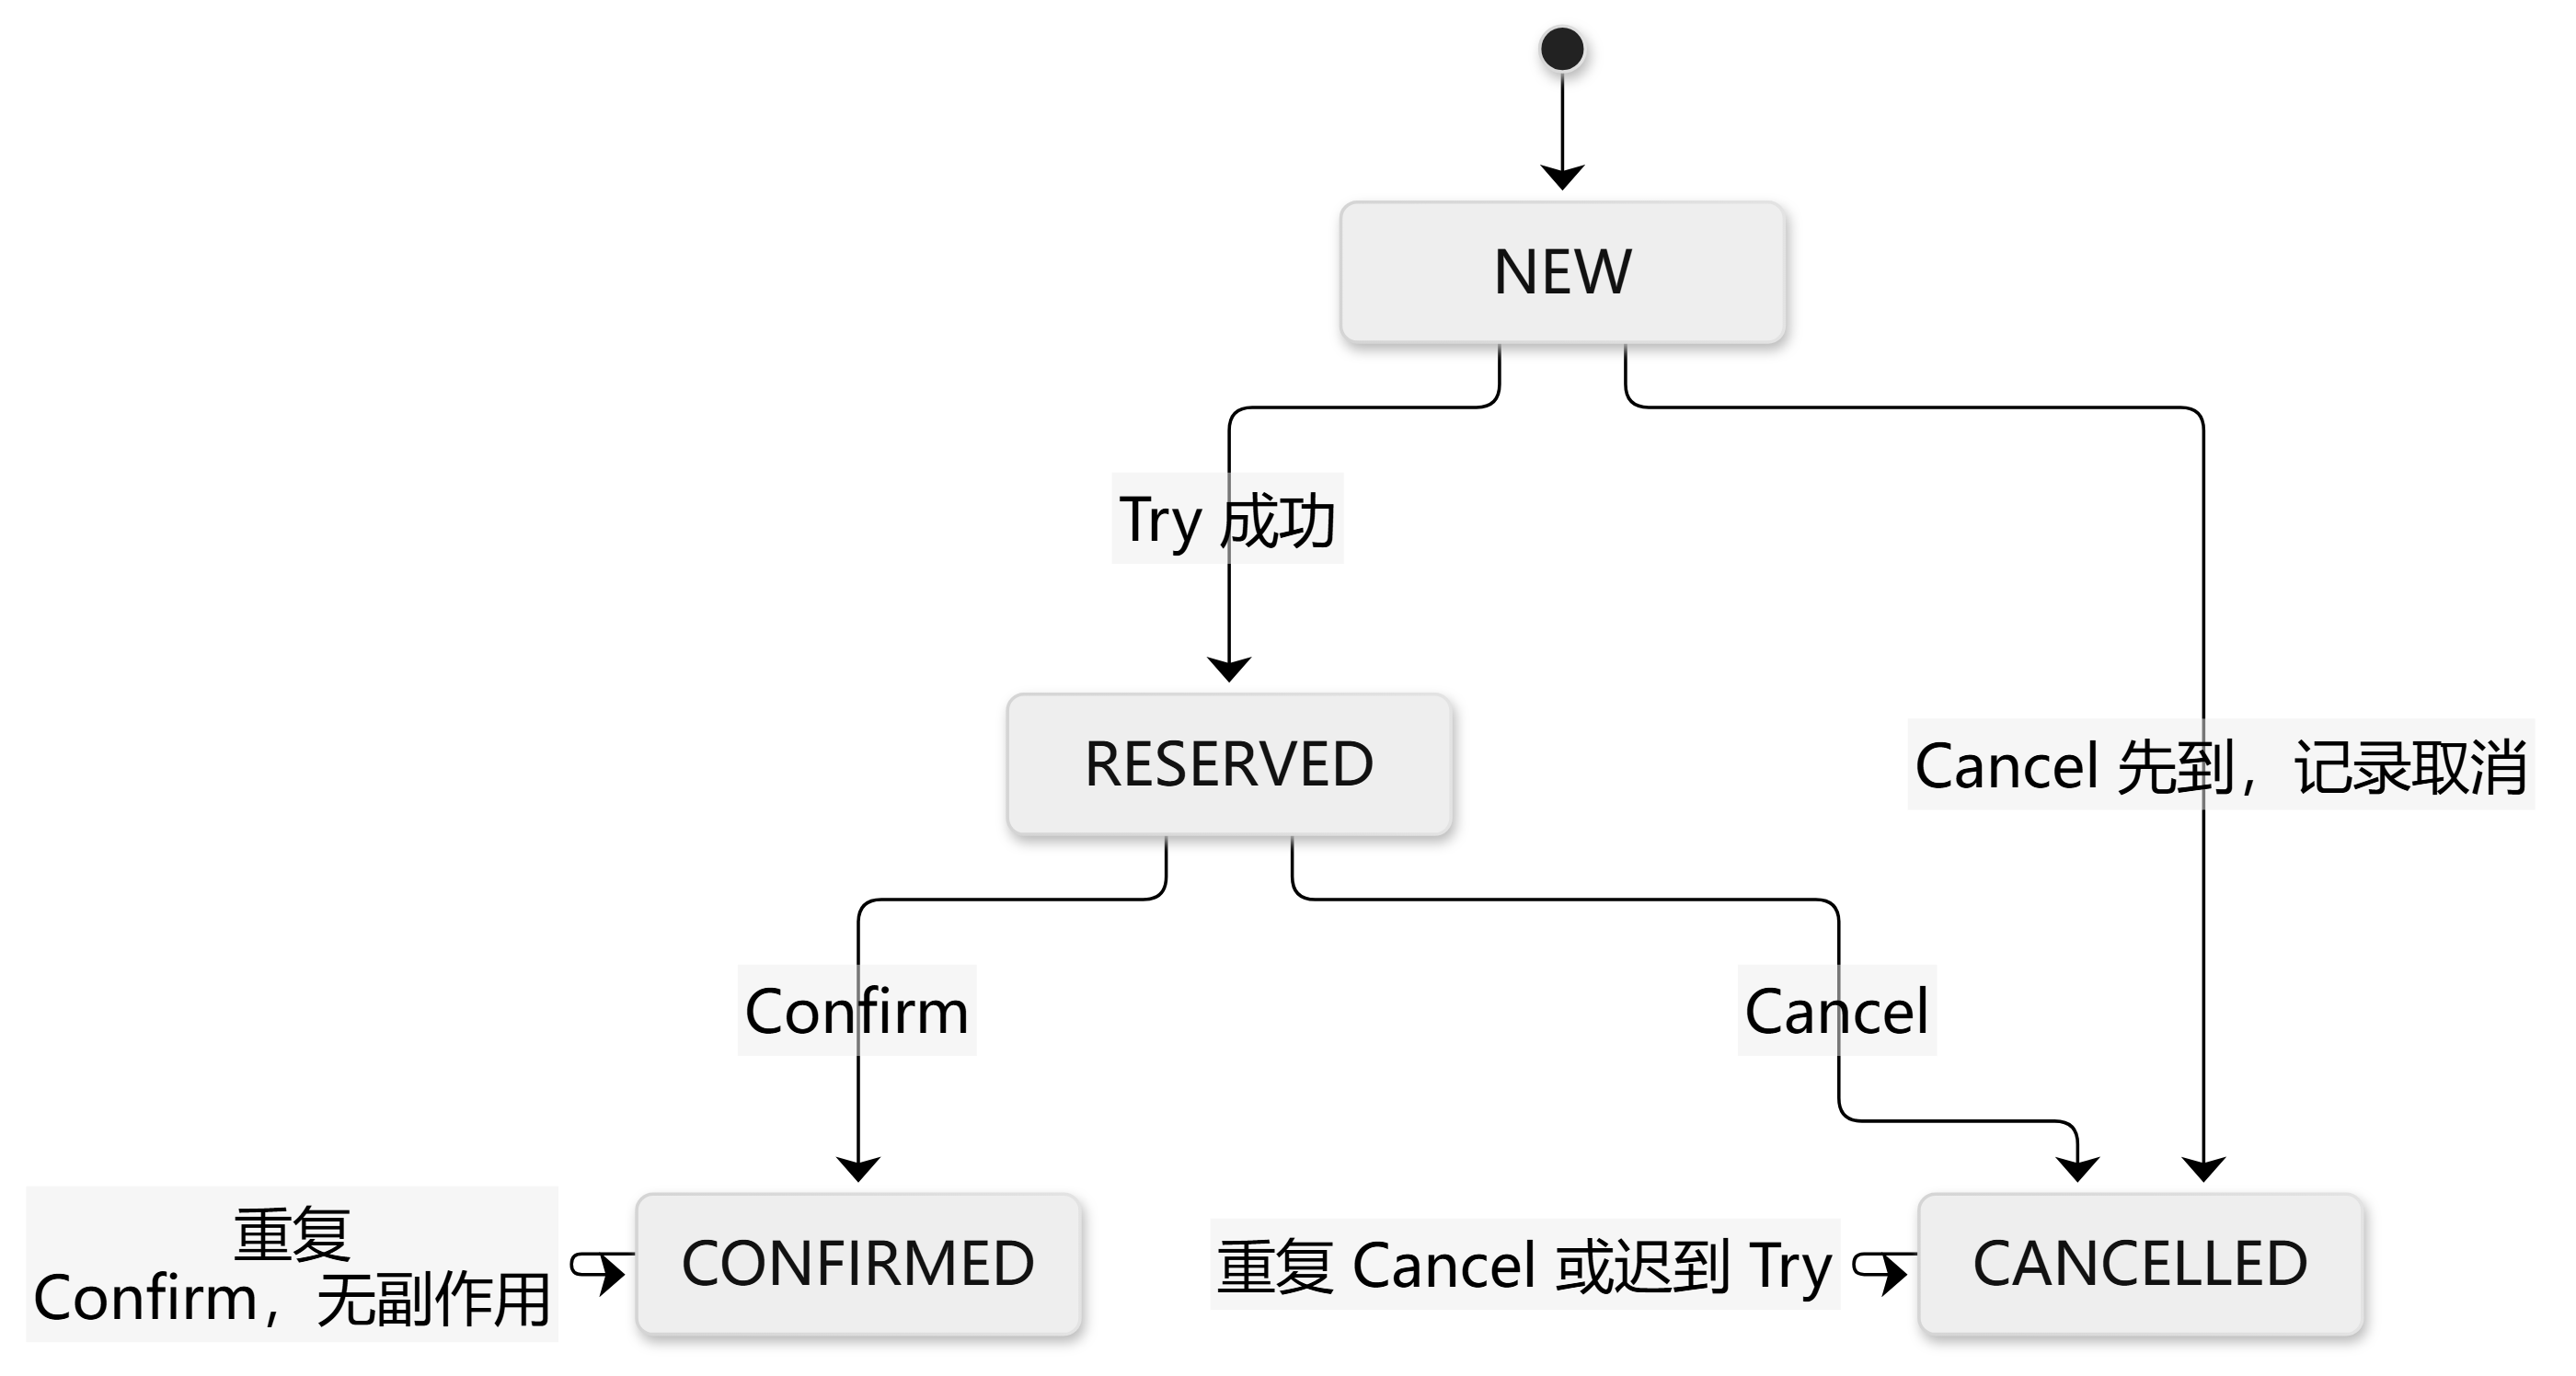
图 3:业务预留状态示意。Try、Confirm、Cancel 的并发竞争需要唯一约束与条件更新;对冲突请求应按已保存的决定返回或拒绝,不能覆盖终态。
3.3 Saga:逐步提交,失败时补偿
Saga 将业务拆为多个本地事务,后续失败时执行相应补偿:
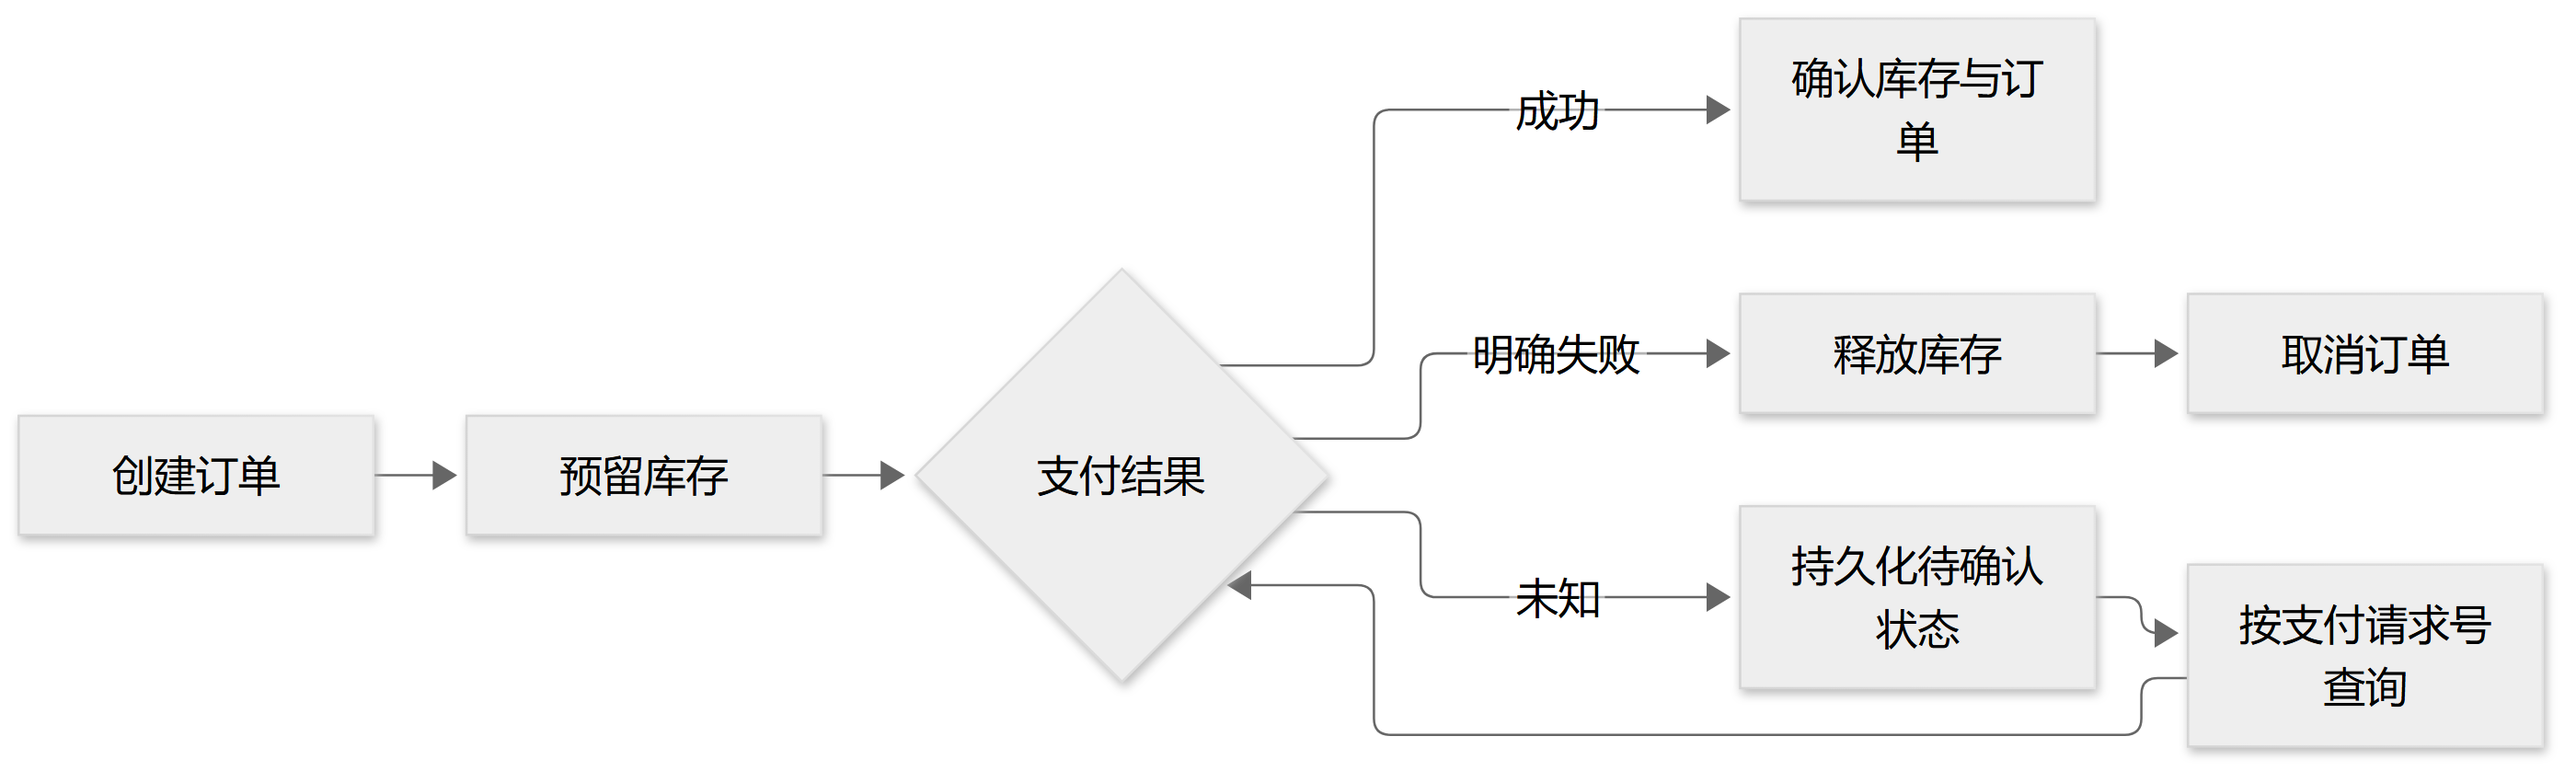
图 4:结果未知需要查询和恢复,不能直接走“明确失败”的补偿分支。查询次数和频率应受预算控制,超出期限升级处理。
如果支付已成功而后续无法履约,补偿可能是退款。退款是一笔新业务操作,可能需要时间,也可能失败,必须继续跟踪。
补偿不等于数据库回滚。 已发送的通知无法彻底撤销,已发生的外部影响也未必能完全恢复,因此必须识别不可逆动作并安排执行时机。
Saga 可以由持久化的流程协调者推动(编排式),也可以由各服务监听事件继续执行(协同式)。它不自动提供跨步骤隔离,需要状态约束防止并发操作破坏业务规则。
适合较长、允许中间状态、能够定义补偿的业务流程。Saga 的原始论文发表于 1987 年,研究的是长事务拆分;现代微服务沿用了这一思路。原始论文介绍、Saga 模式
3.4 Outbox + 幂等消费:让业务变化可靠地传出去
“写数据库,再发消息”存在双写缺口:数据库已提交,进程却在发送消息前崩溃。
Outbox 的做法是把业务修改和待发事件放进同一个本地事务:
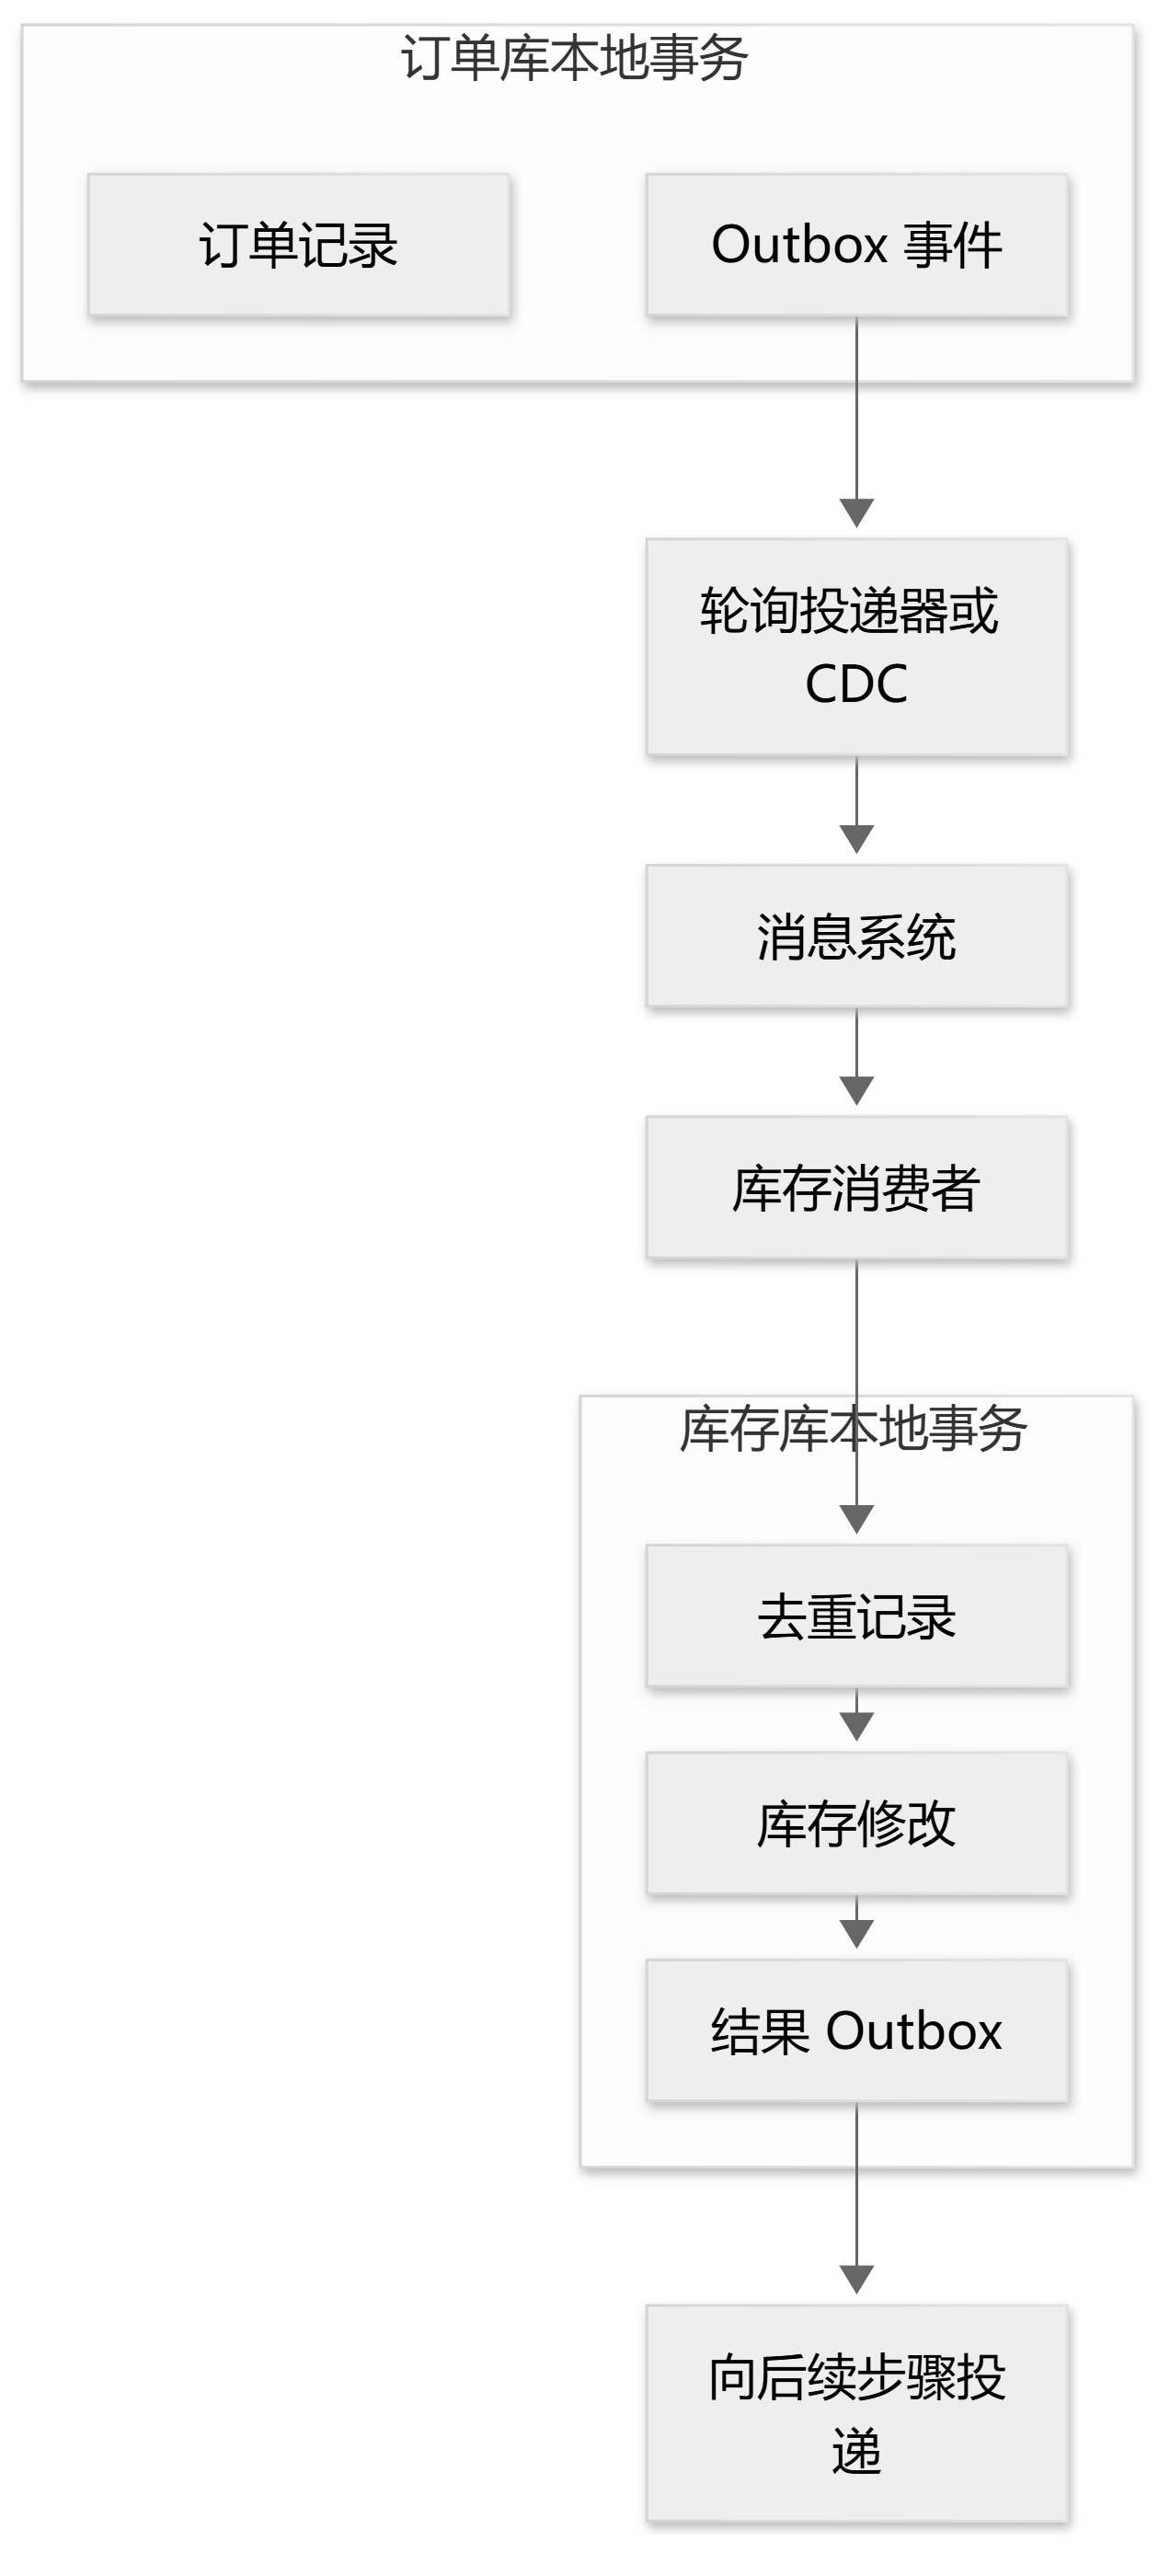
图 5:原子性存在于两个本地事务内部,跨库依靠可靠投递和恢复连接。CDC 是从数据库变更日志捕获已提交变化的机制。
发送成功后、标记已发送前崩溃,仍会造成重复投递,因此消费端必须幂等。去重记录与业务修改要在同一本地事务中提交,否则可能留下“记录处理过,但业务没执行”的缺口。
Outbox 解决业务数据与事件发布的可靠衔接,不保证整个跨服务流程原子提交。它经常与 Saga 组合使用。Transactional Outbox 模式
4. 把方案放回完整业务中
下面是一种教学设计,前提是允许订单短暂处于处理中,库存可预留,支付方提供幂等请求和结果查询:
- 订单服务创建待处理订单,并在同一事务写入 Outbox。
- 库存服务消费事件,在本地事务中去重、预留库存、保存结果事件。
- 流程收到预留成功后,用固定支付请求号发起支付。
- 支付超时则进入结果待确认状态,通过查询或同键安全重试恢复。
- 支付成功后确认库存消耗;条件全部满足才完成订单。
- 支付明确失败时释放库存并取消订单;已付款但无法履约则跟踪退款和资源释放。
处理中 → 已完成
   ↓
补偿中 → 已取消
   ↓
待人工处理
每次状态迁移都应持久化并受条件约束。处理中包含库存、支付等步骤的细分状态;“待人工处理”仍是待解决问题,不能算恢复完成。
外部支付不属于库存或订单的本地数据库事务,因此不能仅靠消费去重覆盖扣款副作用。还要记录支付请求与结果,并处理迟到成功、重复回调和取消冲突。
5. 如何选型?性能是其中一个维度
| 业务条件 | 优先评估方向 | 需要确认的边界 |
|---|---|---|
| 能合理放进同一数据库事务 | 本地事务 | 数据职责与部署边界是否合理 |
| 跨资源必须原子提交 | 2PC / XA | 资源支持、隔离、持锁与恢复成本 |
| 资源可以先预留 | TCC | 预留期限、确认与取消冲突 |
| 长流程、允许中间状态 | Saga | 补偿能力、不可逆步骤与隔离 |
| 业务变化需要异步可靠传播 | Outbox + 幂等消费 | 重复、乱序、积压与收敛时间 |
这些方向可以组合,并不存在统一的“最好方案”。还应考虑团队维护能力、可观测性、故障恢复和业务改造成本。
性能方面,主要成本来自网络协调、持久化、资源占用与重试。异步流程可以较早返回“已受理”,但业务完成仍可能等待队列。
一个实测参考:Spanner 2012 年论文的 2PC 实验中,1、2、5、100 个参与方的平均延迟分别为 17.0、24.5、31.5、71.4 ms。测试环境为 3 个 zone、每个 zone 25 台 spanserver。这说明跨越范围会影响成本,但不是事务开关对照,也不能直接换算为微服务开销。论文 Table 4
实际选型应在相同业务保证下,观察业务完成 P99、有效吞吐、热点锁等待和故障恢复时间,不能只比较接口返回速度。
6. 开源实现与代码:框架承担什么,业务还要做什么
以下是接入片段和教学伪代码,不是可直接部署的完整项目。API 形态按链接中的官方文档核对;使用时应固定组件版本,并补齐依赖、连接配置、认证和恢复配置。示例没有执行集成测试。
6.1 实现地图
| 开源项目 | 对应能力 | 适合研究什么 | 不会自动解决什么 |
|---|---|---|---|
| Narayana | JTA / XA 事务管理与恢复 | 多个 XA 资源的登记、提交与崩溃恢复 | 任意 HTTP 接口或第三方支付的原子性 |
| Apache Seata | AT、TCC、Saga、XA 模式 | 全局事务与分支事务协作 | 业务约束和未接入资源的副作用 |
| DTM | Saga 等分布式事务流程 | 正向动作、补偿动作与重试调度 | 正确的退款规则和外部支付幂等 |
| Debezium | CDC 与 Outbox Event Router | 从数据库日志投递业务事件 | 全局提交、消费端幂等和跨事件业务状态 |
| Apache RocketMQ | 事务消息、结果回查 | 本地事务与消息发布协调 | 消费者业务必然成功 |
这些组件处在不同层次。Debezium 是事件传输的一部分,不能直接与 XA 管理器按“事务能力”互换。
6.2 Seata TCC:明确注册三个业务阶段
下面是 Java 接口片段,展示 Seata 的动作声明;省略依赖、import 和实现类。
@LocalTCC
public interface InventoryAction {
    @TwoPhaseBusinessAction(
        name = "reserveInventory",
        commitMethod = "confirm",
        rollbackMethod = "cancel",
        useTCCFence = true
    )
    boolean reserve(
        BusinessActionContext context,
        @BusinessActionContextParameter(paramName = "orderId") String orderId,
        @BusinessActionContextParameter(paramName = "sku") String sku,
        @BusinessActionContextParameter(paramName = "quantity") int quantity
    );

    boolean confirm(BusinessActionContext context);
    boolean cancel(BusinessActionContext context);
}
调用方还须开启 Seata 全局事务,并通过所用调用链集成传播 XID(全局事务标识);接口注解只声明分支动作,不会自行编排整个下单流程。
参数保存到 action context,供第二阶段恢复使用。Try 实现应在本地事务中检查正数量、条件扣减可售库存并建立预留记录;Confirm 只消耗自己的预留;Cancel 只释放自己的预留。
useTCCFence 配合框架要求的 fence 表和事务集成处理分支级重复与乱序。它不替代订单级唯一约束:用户重试若开启了一个全新全局事务,仍可能重复预留同一订单。应同时约束业务意图标识,并校验同键参数一致。官方 TCC 示例与 Fence 说明
AT 是另一种路径:Seata AT 依赖数据源代理、undo log 和全局锁等机制。第一阶段本地提交业务与回滚日志,失败时通过日志恢复。它不是数据库原生 XA;支持的 SQL、隔离行为以及绕过代理的访问必须单独核查。Seata AT 文档
6.3 DTM Saga:声明正向动作与补偿动作
下面的 Go 片段采用 github.com/dtm-labs/dtmcli 的 NewSaga / Add / Submit 接口形态。req 是已校验的订单请求,gid 是为本次业务意图分配并持久化的稳定事务号。
import "github.com/dtm-labs/dtmcli"

// 片段:置于业务处理函数内;URL 和请求类型由应用定义。
saga := dtmcli.NewSaga(dtmServer, gid).
    Add(orderURL+"/create", orderURL+"/cancel", req).
    Add(stockURL+"/reserve", stockURL+"/release", req)

if err := saga.Submit(); err != nil {
    // 可能是提交响应丢失:保留 gid,查询事务状态并恢复。
    // 不能直接创建新 gid 后再次执行同一业务意图。
    return err
}
// Submit 成功表示提交流程请求成功,不能据此宣布订单全部完成。
接口依据:DTM 官方 Saga 示例、dtmcli Saga 源码。
每个 action 和 compensate 处理器仍要保证业务修改与幂等状态原子提交,正确区分业务失败与临时错误。补偿请求可能先于迟到的正向请求生效,因此还需要防止正向动作在取消后重新执行。不能只在补偿接口写一句“库存加回去”。
示例特意只包含订单和库存;加入外部支付时,需要额外设计支付查询、重复回调、退款失败和迟到成功的状态迁移。
6.4 Outbox:看清 SQL 中的原子边界
以下使用 PostgreSQL 风格 SQL,参数由应用绑定。表结构示意与 Debezium Event Router 常见字段对应;订单表需事先创建。
CREATE TABLE outbox_event (
    id UUID PRIMARY KEY,
    aggregatetype VARCHAR(80) NOT NULL,
    aggregateid VARCHAR(100) NOT NULL,
    type VARCHAR(80) NOT NULL,
    payload JSONB NOT NULL
);

BEGIN;
INSERT INTO orders (id, status) VALUES (:order_id, 'PROCESSING');
INSERT INTO outbox_event
    (id, aggregatetype, aggregateid, type, payload)
VALUES
    (:event_id, 'Order', :order_id, 'OrderCreated', :payload);
COMMIT;
关键点是两次 INSERT 使用同一个数据库连接和事务。请求级幂等可通过稳定订单号与业务唯一约束实现;冲突时查询原订单并校验参数,而不是无条件重建事件。
Debezium 的 Kafka Connect 转换配置片段:
transforms=outbox
transforms.outbox.type=io.debezium.transforms.outbox.EventRouter
它不是完整连接器配置。还需设置数据库、捕获表和逻辑复制等参数,并将转换限定于 Outbox 数据事件,避免误处理心跳或其他表。id 用于事件去重,aggregateid 可作为消息键;同键路由不等于自动具备跨系统业务顺序。官方 Outbox Event Router 文档
消费端最容易出错,下面用 Python 风格伪代码展示真正的分支:
# inbox 上有 UNIQUE(consumer_name, event_id)
with db.transaction() as tx:
    inserted = tx.insert_inbox_if_absent("inventory", event.id)
    if inserted:
        tx.lock_order_state(event.order_id)
        if tx.order_already_cancelled(event.order_id):
            result = "REJECTED_CANCELLED"
        else:
            # 内部使用 available >= quantity 的条件更新;数量必须为正。
            result = tx.reserve_once(event.order_id, event.sku, event.quantity)
        tx.save_result_and_outbox(event.order_id, result)
# 只有上述事务提交成功后,才确认消费;异常让消息重新投递。
message.ack()
去重、订单状态锁、资源修改和结果事件在同一本地事务中。reserve_once 还应通过业务唯一约束防止不同事件 ID 重复执行同一预留。示例中的锁定函数须能处理状态行尚未存在的情况,例如先基于唯一键建立状态行。
| 崩溃点 | 恢复行为 |
|---|---|
| 写订单后、写事件前 | 同事务回滚,不留下孤立订单 |
| 订单事务已提交、尚未投递 | 由投递器或 CDC 从持久化位置继续推进 |
| 消息已发出、投递进度未保存 | 可能重复投递,由消费者去重 |
| 库存已提交、消费确认前 | 重投命中 inbox,不重复预留 |
7. 性能问题:网络开销只是其中一部分
7.1 区分三个指标
接口返回时间、业务完成时间、有效业务吞吐必须分开统计。返回“已受理”可以很快,但支付与库存可能还没有完成。有效吞吐应计算唯一完成业务,不能把重试调用和重复消息都计入成功量。
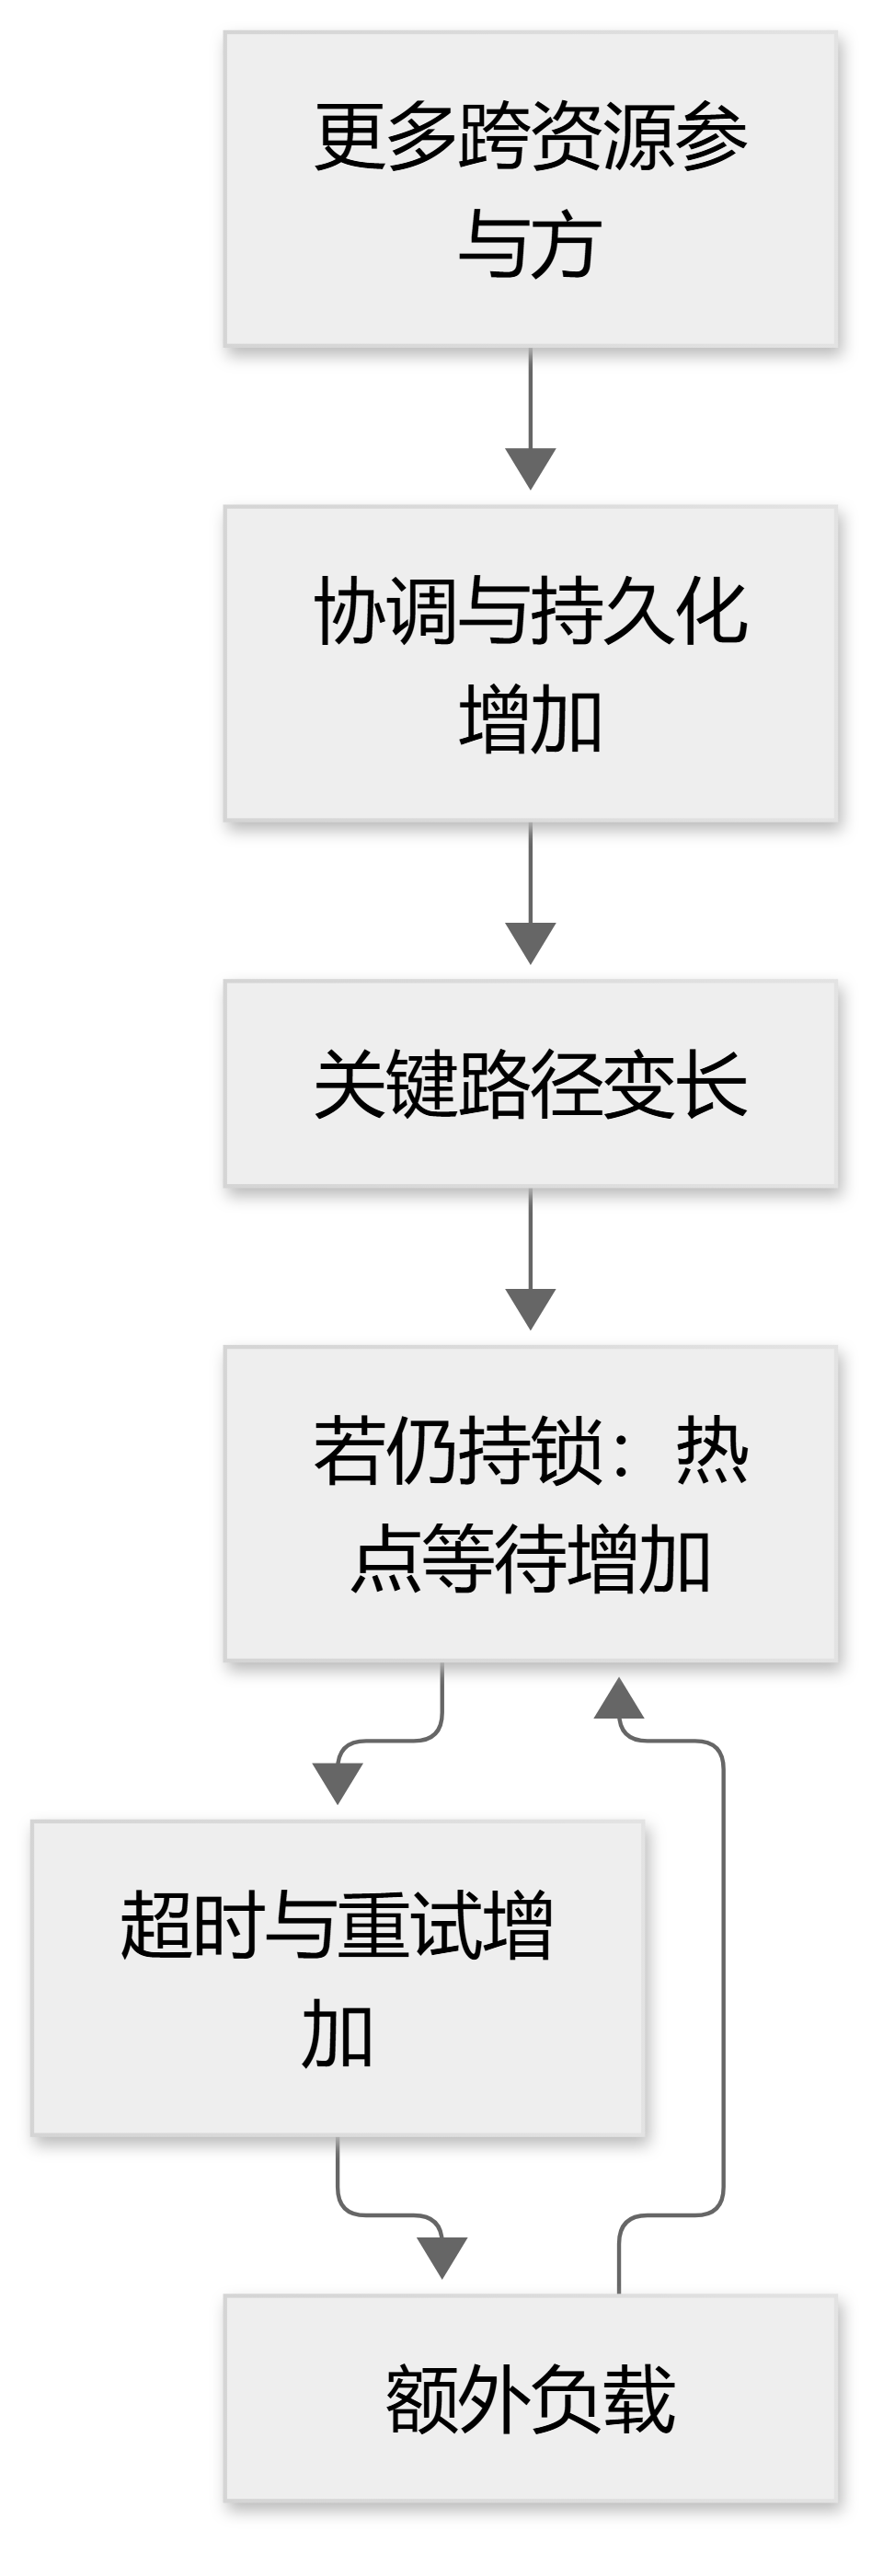
图 6:并发环境中的放大链。单次协调只增加几毫秒,也可能通过热点锁和重试影响大量请求。
7.2 各方案的成本落在哪里
| 方案 | 正常路径成本 | 压力或故障下的风险 | 重点指标 |
|---|---|---|---|
| XA / 2PC | 准备、决定持久化、跨资源通知 | 未决分支持锁、慢节点拖延 | prepared 年龄、锁等待、P99 |
| TCC | 预留、确认/取消、状态存储 | 业务资源长期占用、热点竞争 | 预留年龄、确认延迟、可售比例 |
| Saga | 多个本地提交和步骤通信 | 补偿和重试争抢资源 | 流程完成时间、补偿量、停滞数 |
| Outbox | 事件、去重记录、传输和清理 | 积压、日志保留增长、消费瓶颈 | 最老事件年龄、消费速度、磁盘 |
| Seata AT | 代理处理、undo log、全局锁 | 全局锁竞争、回滚冲突 | 锁等待、回滚时长、日志量 |
TCC 和 Saga 通常缩短单次数据库锁的持续时间,却增加业务状态和恢复工作。不能仅按“阶段数量”排列性能高低。
7.3 论文中的量化结果
Spanner(OSDI 2012)Table 4 的 2PC 扩展性实验:3 个 zone,每个 zone 25 台 spanserver。以下摘取均值和 P99,省略原表标准差,原实验运行 10 次。
| 参与方数量 | 平均延迟 | P99 延迟 |
|---|---|---|
| 1 | 17.0 ms | 75.0 ms |
| 2 | 24.5 ms | 87.6 ms |
| 5 | 31.5 ms | 104.5 ms |
| 50 | 42.7 ms | 93.7 ms |
| 100 | 71.4 ms | 131.2 ms |
| 200 | 150.5 ms | 320.3 ms |
按均值计算,2 个参与方比 1 个增加约 44%;100 个约为基线的 4.2 倍。P99 不严格单调,应结合波动理解。原论文 Table 4
这些是历史实测,衡量跨资源范围变化,不是“开启/关闭事务”对照,也不是当前产品性能。参与方不等于微服务;表格不能用于计算增加一个业务服务的固定开销。
7.4 两个容量推导示例
热点锁。 若所有操作独占同一库存锁,每次持锁 5 ms,理想串行上限约 200 次/秒;若延长到 50 ms,则约 20 次/秒。这是单热点的简化模型,不是整库 TPS。无冲突访问、批处理等条件会改变模型。
异步积压。 入口 1,000 笔/秒、后台 800 笔/秒,持续一分钟新增约 12,000 笔积压。后台恢复到 1,200 笔/秒但入口仍保持 1,000 笔/秒时,净消化能力只有 200 笔/秒,理想清空时间约 60 秒。
两组数字是教学计算。它们说明容量应覆盖热点和恢复流量,不能只满足正常平均负载。
7.5 可复用的压测与优化方法
先固定事务保证、隔离要求、机器资源、数据规模和持久化配置,再改变一个因素。否则“更快”可能只是做了更少的工作或降低了保证。
| 场景 | 变量 | 观察结果 |
|---|---|---|
| 正常负载 | 逐级增加到达速率 | 首次违反 P99 目标的负载点 |
| 热点负载 | 均匀访问到集中购买少数 SKU | 锁等待与有效吞吐变化 |
| 慢分支 | 为单个参与方增加延迟 | 整体延迟、重试和连接等待 |
| 短暂故障 | 暂停消费者或重启协调者 | 未决事务与积压峰值 |
| 故障恢复 | 保持新流量持续进入 | 消化积压所需时间和错误终态 |
同时报告受理量、唯一成功量、业务拒绝、技术失败和未完成业务年龄。不要只对已完成请求计算漂亮的延迟,也要检查压测客户端是否因等待响应而自动降低了实际到达速率。
优化优先级:缩小跨资源范围 → 缩短持锁时间 → 缓解热点 → 并行无依赖步骤 → 合理批处理 → 背压与限流 → 控制重试与恢复负载。每一步都要重新检查正确性;例如拆库存配额后还要证明配额总量守恒。
8. 无论选择什么方案,都需要这些能力
| 能力 | 要解决的问题 |
|---|---|
| 业务幂等 | 同一意图重复到达,只产生一次有效结果;同键不同参数应拒绝 |
| 持久化状态机 | 重启后知道执行到了哪里,阻止过期或非法操作 |
| 有边界的重试 | 区分瞬时故障、业务拒绝和结果未知;控制重试频率与总预算 |
| 对账与恢复 | 找出支付、订单、库存之间的偏差,并安全推进或补偿 |
| 监控与人工处理 | 发现长期未决、补偿失败和积压,并明确处理责任 |
验证方案时,主动模拟四种故障:消息重复到达;业务提交后响应丢失;进程在提交点附近崩溃;补偿执行失败。
每种故障都应回答:谁保存了事实?谁继续推进?重复执行安全吗?多久告警?无法自动恢复时由谁处理?
9. 带走三个判断
- 先定义业务规则和事务边界。 本地事务不能自动覆盖远程副作用。
- 选方案就是选择保证和代价。 原子提交、业务预留、补偿和可靠消息各有边界。
- 恢复机制是方案本身的一部分。 只有正常路径能运行,还不算完成分布式事务设计。
讨论题:如果“库存预留成功、支付结果未知、用户此时申请取消”同时发生,我们应该保存哪些状态,由谁作出决定,如何处理迟到的支付成功?
延伸阅读
- Consensus on Transaction Commit:事务提交、阻塞与共识的关系。
- Sagas:长事务拆分与补偿的起点。
- Life beyond Distributed Transactions:应用层实体、消息和一致性设计。
- Spanner:数据库层分布式事务的系统实践。
建议先掌握本文业务案例和四类方案,再读原始论文深化对保证和失败模型的理解。