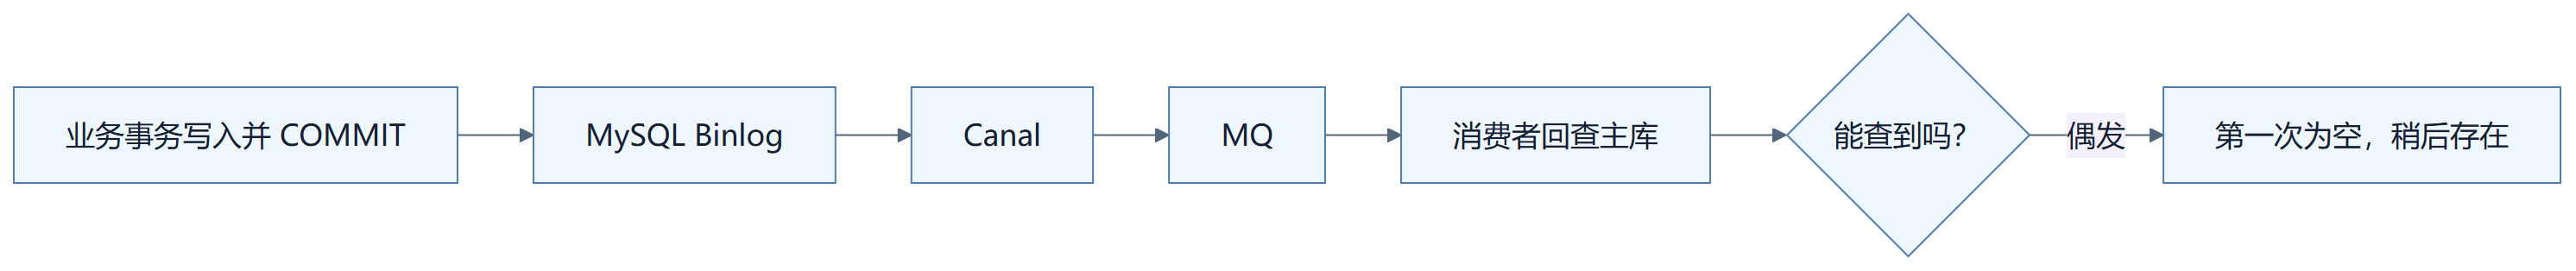
在一条常见的 CDC 链路中,Canal 订阅 MySQL Binlog,将订单变更投递到 MQ;消费者收到消息后,再按主键回查主库获取完整数据。
低流量时一切正常,流量上来后却偶尔出现一种反直觉的现象:Canal 已经收到 INSERT,消费者立即回查同一台主库却返回空,稍后重试又能查到。
查询能否看到一条记录取决于事务可见性,不要求脏页已经落盘,因此“数据页还没刷盘”无法解释这个现象。排查范围需要覆盖 MySQL 提交、Binlog Dump 和 Canal 投递三条链路。
源码基线:MySQL 8.0.46、Canal
87be50e
现象与前提
典型链路如下:
在分析源码之前,先排除几类更常见的问题。
确认查询的是同一台主库
不要只看域名或代理配置。异常发生时,应同时记录 Canal 来源实例和查询目标实例:
SELECT @@hostname,
       @@port,
       @@GLOBAL.server_uuid,
       @@read_only,
       @@super_read_only;
主从切换、代理路由或分片配置错误,都可能制造相同症状。
排除旧 Read View
MySQL 默认隔离级别是 REPEATABLE READ。如果消费者复用了一个已经做过一致性读的长事务,即使目标事务已经提交,旧 Read View 仍可能看不到新数据。
SELECT @@autocommit, @@transaction_isolation;
复现和取证时,建议使用 autocommit=1 的新连接。
确认 Canal 收到的是完整事务
检查消息中是否出现 TRANSACTIONEND/XID,以及 Canal、MQ 的 batch 是否拆分了大事务。Canal 默认的 canal.instance.transaction.size=1024,缓冲区满时可能切分投递。
检查完整事件序列
按 GTID、Binlog file/position 和主键检查后续事件,排除乱序、重复消费、插入后删除或补偿事务。
排除这些因素后,问题就可以归结为:
Binlog 已经对 Dump 线程可读,但 InnoDB 事务还没有对主库其他会话可见。
MySQL 提交链路中的可见性窗口
XID 先进入 Binlog cache
事务发起 COMMIT 时,MySQL 会构造 Xid_log_event,或构造代表 COMMIT 的 Query_log_event,再调用 trx_cache.finalize():
Xid_log_event end_evt(thd, xid);
cache_mngr->trx_cache.finalize(thd, &end_evt);
此时 Binlog cache 已经包含完整的事务边界。因此,Canal 读到 XID,只能说明 Binlog 事务完整,不能说明主库的 InnoDB commit 已完成。
ordered_commit() 的三个阶段
MySQL 8.0 的核心提交流程位于 MYSQL_BIN_LOG::ordered_commit():
MYSQL_BIN_LOG::ordered_commit(...)
{
    process_flush_stage_queue(...);  // Stage 1: FLUSH
    sync_binlog_file(false);         // Stage 2: SYNC
    update_binlog_end_pos();         // Dump 线程可以读取

    call_after_sync_hook(...);       // AFTER_SYNC 在这里等待 ACK
    process_commit_stage_queue(...); // Stage 3: 提交 InnoDB
    process_after_commit_stage_queue(...);
}
当 sync_binlog=1 时,MySQL 在 sync 成功后更新 binlog_end_pos;当 sync_binlog!=1 时,通常在 flush 后发布新的 end position。无论走哪条路径,Binlog 的发布都可能发生在 engine commit 之前。
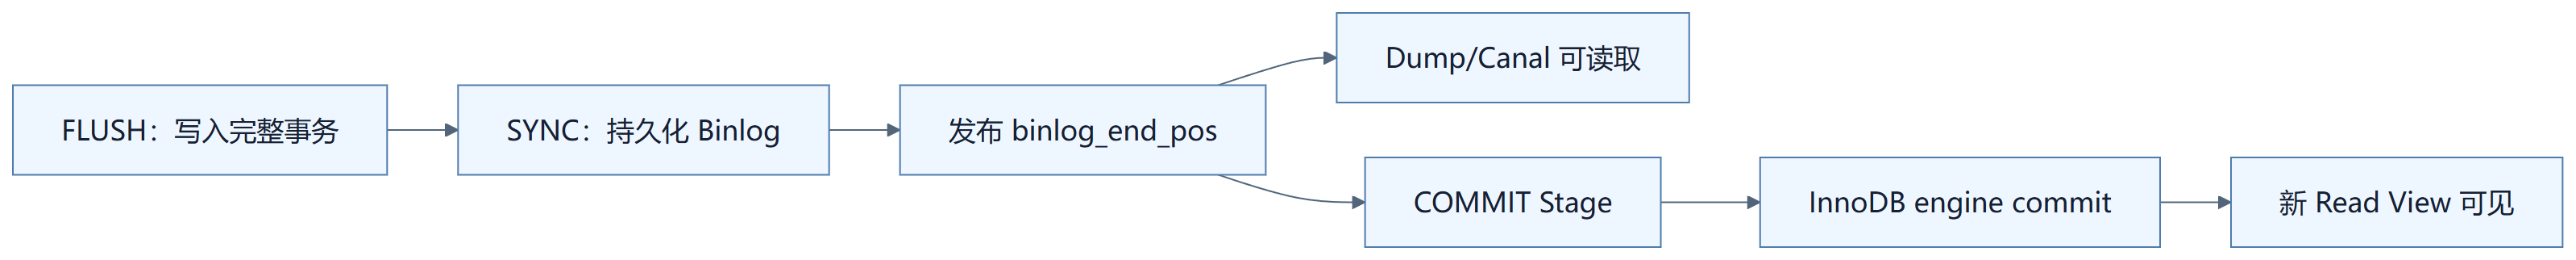
Dump 线程不等待 InnoDB commit
Binlog Dump 线程通过 Binlog_sender::get_binlog_end_pos() 判断是否有新内容:
end_pos = mysql_bin_log.get_binlog_end_pos();
if (log_pos < end_pos)
    return end_pos;

send_events(log_cache, end_pos);
它只检查这段 Binlog 是否已经发布为可读取,不检查对应的 InnoDB 事务是否已经提交。因此,在 binlog_end_pos 发布之后,Dump 线程和提交线程会并发推进:
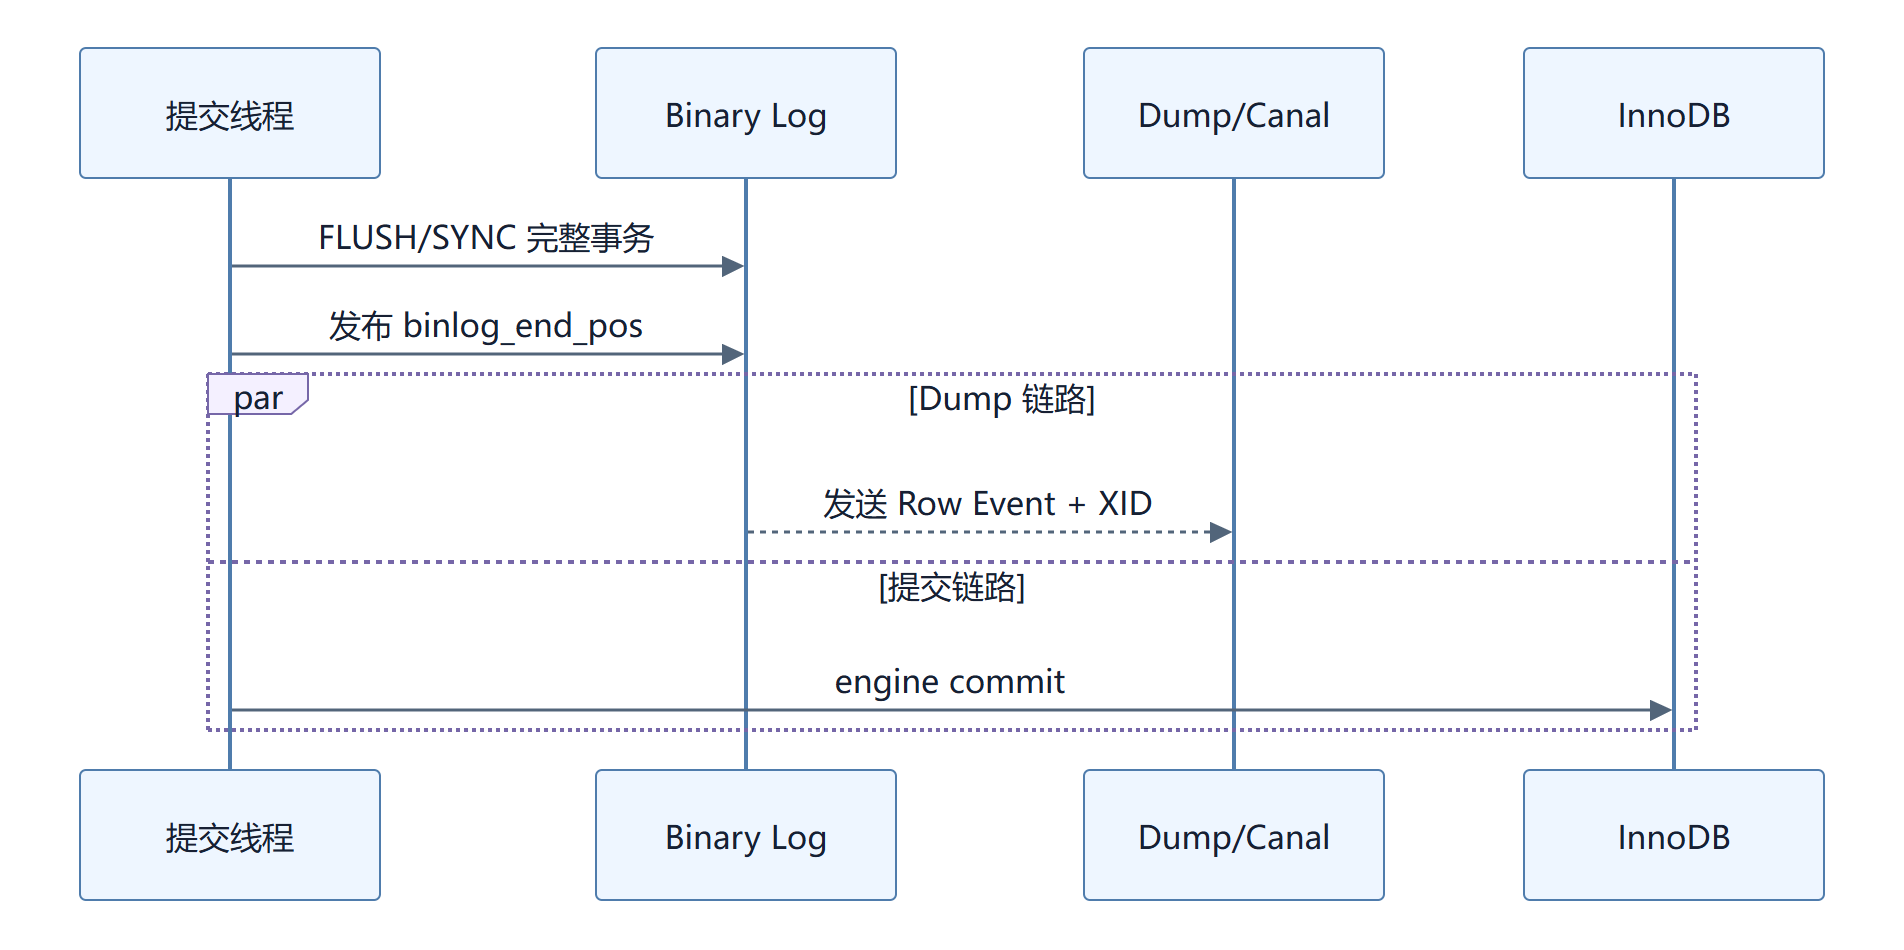
谁先完成,取决于提交队列、线程调度、半同步等待、网络速度以及 Canal/MQ 的处理速度。
Canal 对完整事务的投递
Canal 的 LogEventConvert.parseXidEvent() 会把 MySQL XID 转换成 TRANSACTIONEND:
private Entry parseXidEvent(XidLogEvent event) {
    TransactionEnd end = createTransactionEnd(event.getXid());
    return createEntry(header, EntryType.TRANSACTIONEND, end.toByteString());
}
EventTransactionBuffer 收到 TRANSACTIONEND 后立即 flush:
case TRANSACTIONEND:
    put(entry);
    flush();
    break;
所以 Canal 的事务语义是:
- 已经收到完整的 Binlog 事务边界;
- 可以将事务交给 EventSink;
- 不会额外等待主库的
gtid_executed或 InnoDB commit 状态。
如果 Canal 还承担半同步 ACK,其源码顺序同样是先 sink 或 transactionBuffer.add(),再 sendSemiAck()。不过,仅设置 JVM 参数 db.semi=1 不代表半同步链路已经生效,还要验证主库插件、连接会话标记和运行状态。
三种复制模式的差异
| 模式 | Canal 先收到、主库暂时不可见 | 窗口大小 | 原因 |
|---|---|---|---|
| 异步复制 | 可能 | 通常很短 | Dump 与 engine commit 并发 |
半同步 AFTER_COMMIT | 可能 | 通常很短 | ACK 在 commit 后,但 Dump 仍可能提前发送 |
半同步 AFTER_SYNC | 可能且最明显 | 可能明显变长 | commit 前等待副本 ACK |
半同步 AFTER_SYNC
AFTER_SYNC 将 ACK 等待放在 Binlog sync 和 engine commit 之间:
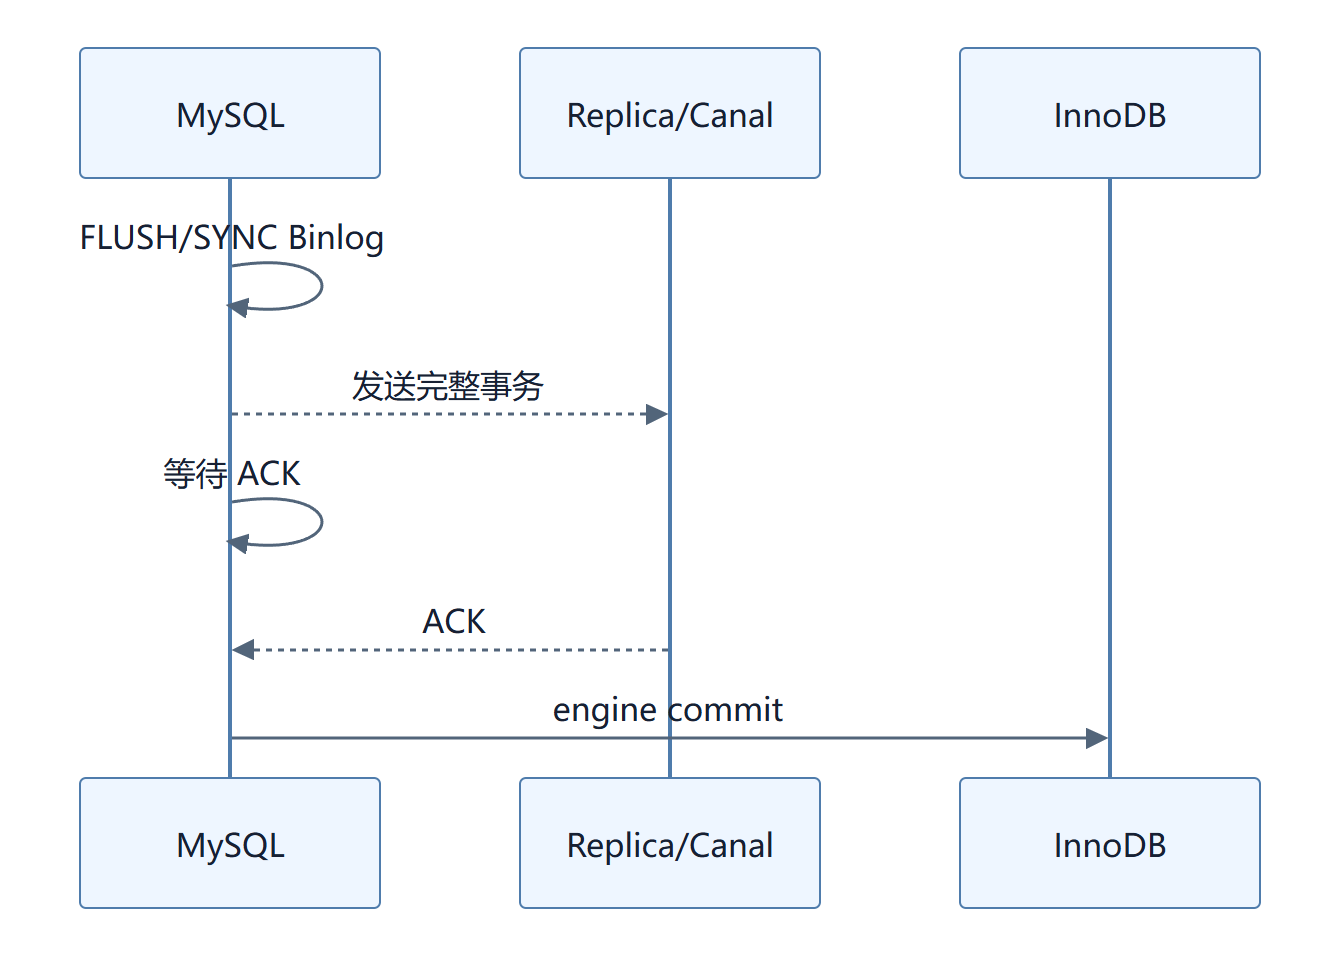
网络 RTT、副本写入或 ACK 处理越慢,这个窗口就越长。因此,AFTER_SYNC 模式在线上更容易观察,也更容易用 GDB 稳定复现。
半同步 AFTER_COMMIT
AFTER_COMMIT 把 ACK 等待移到 InnoDB commit 之后,去掉了 commit 前的长等待。但 Dump 线程仍可能在 engine commit 前被唤醒,因此它只能显著缩短窗口,不能从源码上保证窗口为零。
用 GDB 稳定复现
携程 DBA 曾采用类似方法复现该问题:在主库半同步等待函数上打断点,观察主库和副本的 GTID 与数据可见性。
测试条件:
- MySQL 8.0,存储引擎为 InnoDB;
- GTID 已开启;
- 半同步复制已启用且实际处于 ON;
rpl_semi_sync_source_wait_point=AFTER_SYNC;- 有一个副本或 ACK 客户端;
- Canal 连接同一台主库。
创建测试表:
CREATE TABLE gtid_debug (
    id   INT NOT NULL AUTO_INCREMENT,
    name VARCHAR(32),
    PRIMARY KEY (id)
) ENGINE=InnoDB;
MySQL 8.0 对应的关键断点:
set pagination off
set breakpoint pending on
break ReplSemiSyncMaster::commitTrx
continue
虽然 MySQL 8.0 的配置变量已经采用 source/replica 术语,源码类名仍保留 ReplSemiSyncMaster。这个函数属于半同步插件,用于等待副本 ACK;InnoDB commit 在其他位置执行。
Session 1 执行:
INSERT INTO gtid_debug(name) VALUES ('test1');
COMMIT;
提交线程进入 ReplSemiSyncMaster::commitTrx() 后,Canal 或副本此时可能已经收到该事务。使用新的 Session 查询:
SELECT * FROM gtid_debug WHERE name = 'test1';
在主库 InnoDB commit 尚未完成时,结果为空;提交线程继续执行并完成 commit 后,再查即可看到记录。
需要注意,GDB 默认使用 all-stop 模式,断点命中时会暂停整个 mysqld。实际操作应在测试环境中确认调用栈后继续运行,让提交线程自然阻塞在 ACK 等待;也可以使用 non-stop 调试,只暂停目标线程。发行包若被 strip,还需要安装完全匹配的 debug symbols。
若要验证异步复制或 AFTER_COMMIT 下的基础竞态,可在测试版本中使用 MySQL DEBUG_SYNC 点:
bgc_after_sync_stage_before_commit_stage
也可以在 update_binlog_end_pos() 之后、process_commit_stage_queue() 之前暂停目标提交线程,同时让 Dump 线程继续运行。
高流量下的窗口数量与长度
低流量下也存在这个窗口。高流量会同时增加窗口的数量和长度。
命中小窗口的机会变多
可以粗略估算:
处于“Binlog 已发布、InnoDB 未提交”状态的事务数
≈ 每秒事务数 × 平均可见性窗口
假设峰值是 10 万 TPS:
| 平均窗口 | 同时处于窗口内的事务数 |
|---|---|
| 50 μs | 约 5 个 |
| 500 μs | 约 50 个 |
| 1 ms | 约 100 个 |
低流量时,即使窗口始终存在也很难碰到;高流量时,系统中几乎随时都有事务处在中间状态。
Group Commit 批次变大
高并发下,MySQL 会把更多事务组成一个 Group Commit 批次。Binlog end position 可以一次覆盖整批事务,Dump 线程随即开始读取;而 engine commit 阶段仍需遍历提交队列。越靠近队尾的事务,可见性窗口通常越长。
ACK 与调度延迟增加
高流量还可能带来:
- Binlog Dump 网络队列积压;
- 副本 relay log 写入变慢;
- ACK receiver 竞争;
- 多副本 ACK 等待;
- commit queue 排队或提交顺序控制竞争;
- 提交线程被操作系统暂时换出,而 Dump、Canal 和 MQ 线程先获得 CPU。
需要区分的是:变慢发生在 Binlog 发布之前,还是发布之后、engine commit 之前。只有后一段会直接扩大本文讨论的可见性窗口。
| 机制 | 会让 COMMIT 总耗时变长 | 会直接扩大发布后窗口 |
|---|---|---|
| 行锁等待、死锁检测 | 会 | 通常不会,完整事务尚未发布 |
| Binlog fsync | 会 | sync_binlog=1 时通常发生在发布前 |
| Redo prepare/flush | 会 | 很多工作发生在发布前 |
| 脏页后台刷盘 | 可能造成系统压力 | 与可见性没有直接关系 |
AFTER_SYNC 等待 ACK | 会 | 会,而且很直接 |
| Commit queue/线程调度 | 会 | 会 |
线上如何确认
确认这个问题时,应把 Canal 收到时间、GTID 和主库提交状态记录在同一条链路日志中。
记录必要字段
- GTID;
- Binlog file、end_log_pos;
- MySQL server UUID;
- schema、table 和主键;
- Canal 接收、MQ 发送和消费时间;
- 第一次查询及每次重试时间;
- 查询目标的
@@server_uuid。
检查 GTID 是否已经提交
SELECT GTID_SUBSET(:event_gtid, @@GLOBAL.gtid_executed) AS committed_here;
如果 Canal 已收到消息,但第一次检查返回 0,稍后变为 1,就能直接证明该 GTID 当时还没有进入目标主库的 executed 集合。
也可以使用带超时的等待:
SELECT WAIT_FOR_EXECUTED_GTID_SET(:event_gtid, 1.0) AS wait_result;
返回 0 表示等待成功,返回 1 表示超时。等待结束后,应使用新的事务或新的 Read View 查询。
检查半同步状态
SHOW GLOBAL VARIABLES LIKE 'rpl_semi_sync%';
SHOW GLOBAL STATUS LIKE 'Rpl_semi_sync%';
重点关注:当前是否处于半同步、wait_point、平均 ACK 等待时间、当前等待会话数、timeout 次数,以及是否已降级为异步。
检查提交压力
SHOW GLOBAL VARIABLES LIKE 'sync_binlog';
SHOW GLOBAL VARIABLES LIKE 'binlog_order_commits';
SHOW GLOBAL VARIABLES LIKE 'binlog_group_commit_sync_delay';
SHOW GLOBAL VARIABLES LIKE 'innodb_flush_log_at_trx_commit';

SHOW GLOBAL STATUS LIKE 'Innodb_log_waits';
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool_wait_free';
SHOW GLOBAL STATUS LIKE 'Threads_running';
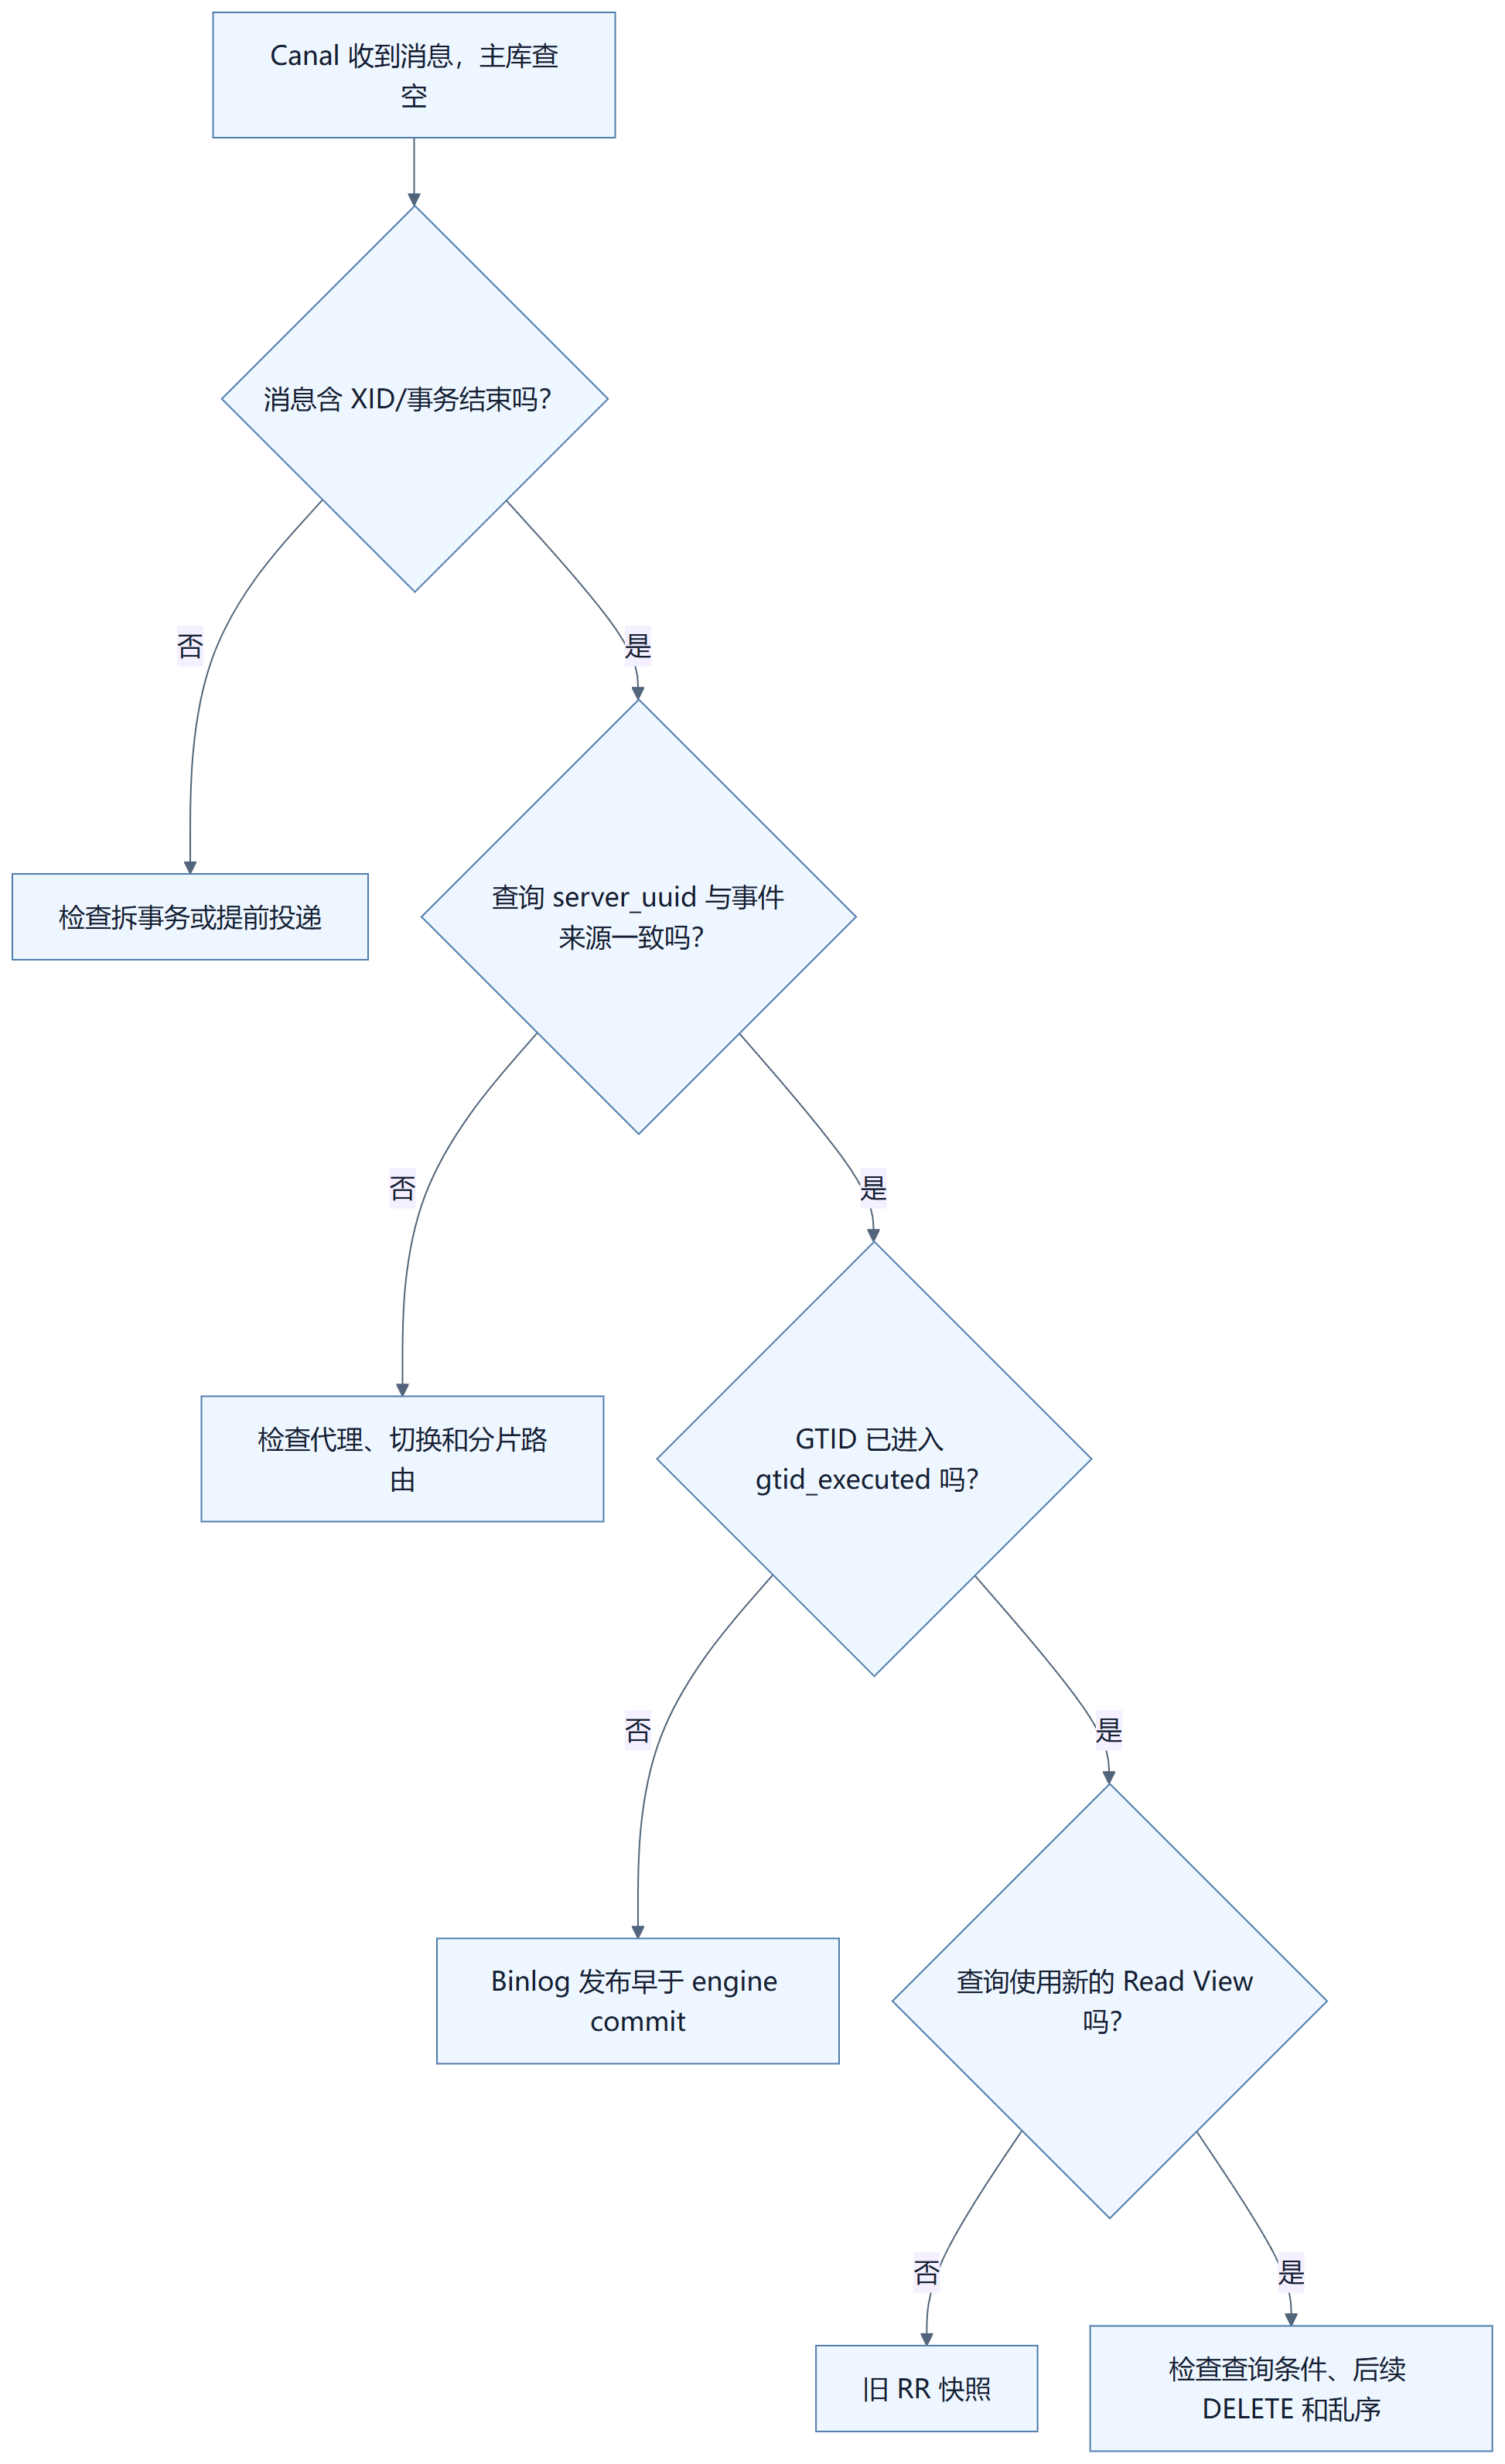
排查顺序可以归纳为:
解决方案
方案一:直接使用 Binlog after image
优先使用这种做法。如果下游需要的字段已经在 Canal 的 afterColumns 中,就直接处理事件内容,不再回查主库。
优点很直接:
- 消除事件后立即回查的竞态;
- 降低主库读压力;
- 处理的数据版本与 Binlog 版本一致。
如果 UPDATE 需要完整行,可以评估 binlog_row_image=FULL。对于 10 万级 TPS,这通常比每条消息额外查询一次数据库更合理。
方案二:增加 GTID 可见性屏障
如果业务必须回查主库,让消息携带 GTID,并在查询前等待目标主库执行该 GTID:
SELECT WAIT_FOR_EXECUTED_GTID_SET(:event_gtid, :timeout);
高吞吐场景不建议每条消息都单独执行一次等待 SQL。可以按源实例和消费分区合并 GTID watermark、批量等待,或仅在第一次查空时进入 GTID barrier。
需要避免环形等待:如果某组件是主库唯一要求的半同步 ACK 方,就不能让它等待主库 commit 后才回 ACK。
方案三:仅对查空进行有限退避
有限退避通常容易接入现有消费逻辑:
第一次查空 → 5 ms → 20 ms → 50 ms → 100 ms → 延迟队列/告警
重试应满足四个条件:有总时间预算、操作幂等、只对符合特征的查空重试,超限后进入延迟队列,避免无限阻塞消费线程。
携程案例最终采用了固定延迟 1 秒。它能缓解问题,但无法证明事务已经提交;有限退避或 GTID 屏障更稳妥。
方案四:谨慎使用 locking read
低流量且明确按主键查询时,可以考虑:
SELECT * FROM orders WHERE id = ? FOR SHARE;
锁定读会尝试读取最新状态,并可能等待冲突事务结束,但会增加锁和连接压力,不适合作为高吞吐 CDC 链路的默认方案。
方案五:评估切换到 AFTER_COMMIT
AFTER_COMMIT 能消除 commit 前的半同步 ACK 等待,通常可以明显降低问题概率,但不能严格保证 Canal 一定晚于 engine commit。
此外,AFTER_COMMIT 允许事务先在旧主库对其他会话可见,再等待副本 ACK。如果此时旧主库宕机并发生切换,可能出现“刚才查到的数据在新主库不存在”的故障语义。因此,不能只为降低这个问题的概率就直接切换,必须由 DBA 结合 RPO 和切换策略评估。